Te llega un fichero CSV. Antes de cargarlo en una base de datos, quieres saber qué columnas tiene, si faltan valores y qué registros te interesan. Abrir una hoja de cálculo funciona, pero resulta poco cómodo cuando tienes que repetir la misma operación con varios archivos. Escribir un programa para cada comprobación tampoco siempre compensa.
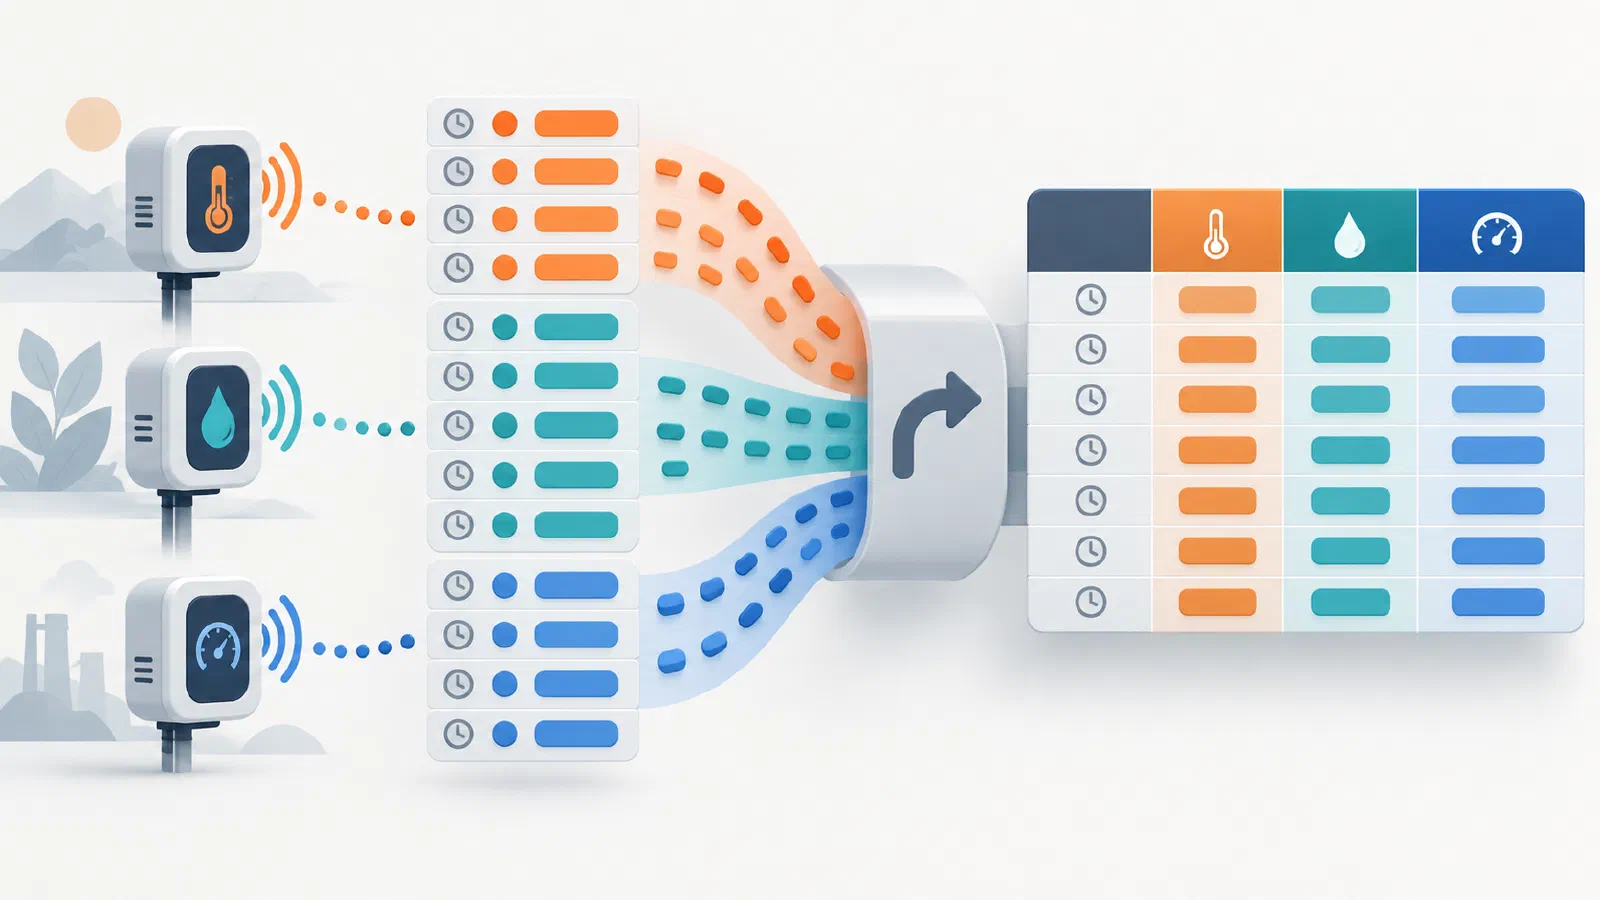
Imagina que recibes lecturas de sensores cada cinco minutos. Cada mensaje contiene un instante, el sensor que lo envió, el nombre de una métrica y su valor. Guardar los mensajes tal como llegan es cómodo: si mañana aparece una métrica nueva, basta con recibir más filas. Pero el informe que consume esos datos pide otra cosa: una fila por instante y sensor, con temperatura, humedad y presión en columnas separadas.
Hay herramientas que resuelven una tarea concreta y otras que terminan convirtiéndose en el cajón de herramientas entero. DBeaver pertenece a la segunda categoría: es un cliente de bases de datos multiplataforma desde el que podemos conectarnos, consultar, explorar, editar y exportar datos sin cambiar de aplicación. Para un data engineer, se parece bastante a una navaja suiza con una interfaz gráfica.
Hay herramientas que aparecen en los pipelines de datos porque una gran empresa las impone y otras que se extienden porque resuelven un problema cotidiano con una elegancia difícil de ignorar. DuckDB pertenece a la segunda categoría. Es una base de datos analítica embebida, pequeña, rápida y capaz de consultar archivos locales o remotos con SQL. En los últimos años se ha convertido en una pieza habitual del trabajo de Data Engineering, Data Science y Analytics Engineering.
