
PIVOT en SQL Server: de lecturas de sensores a una tabla por instante
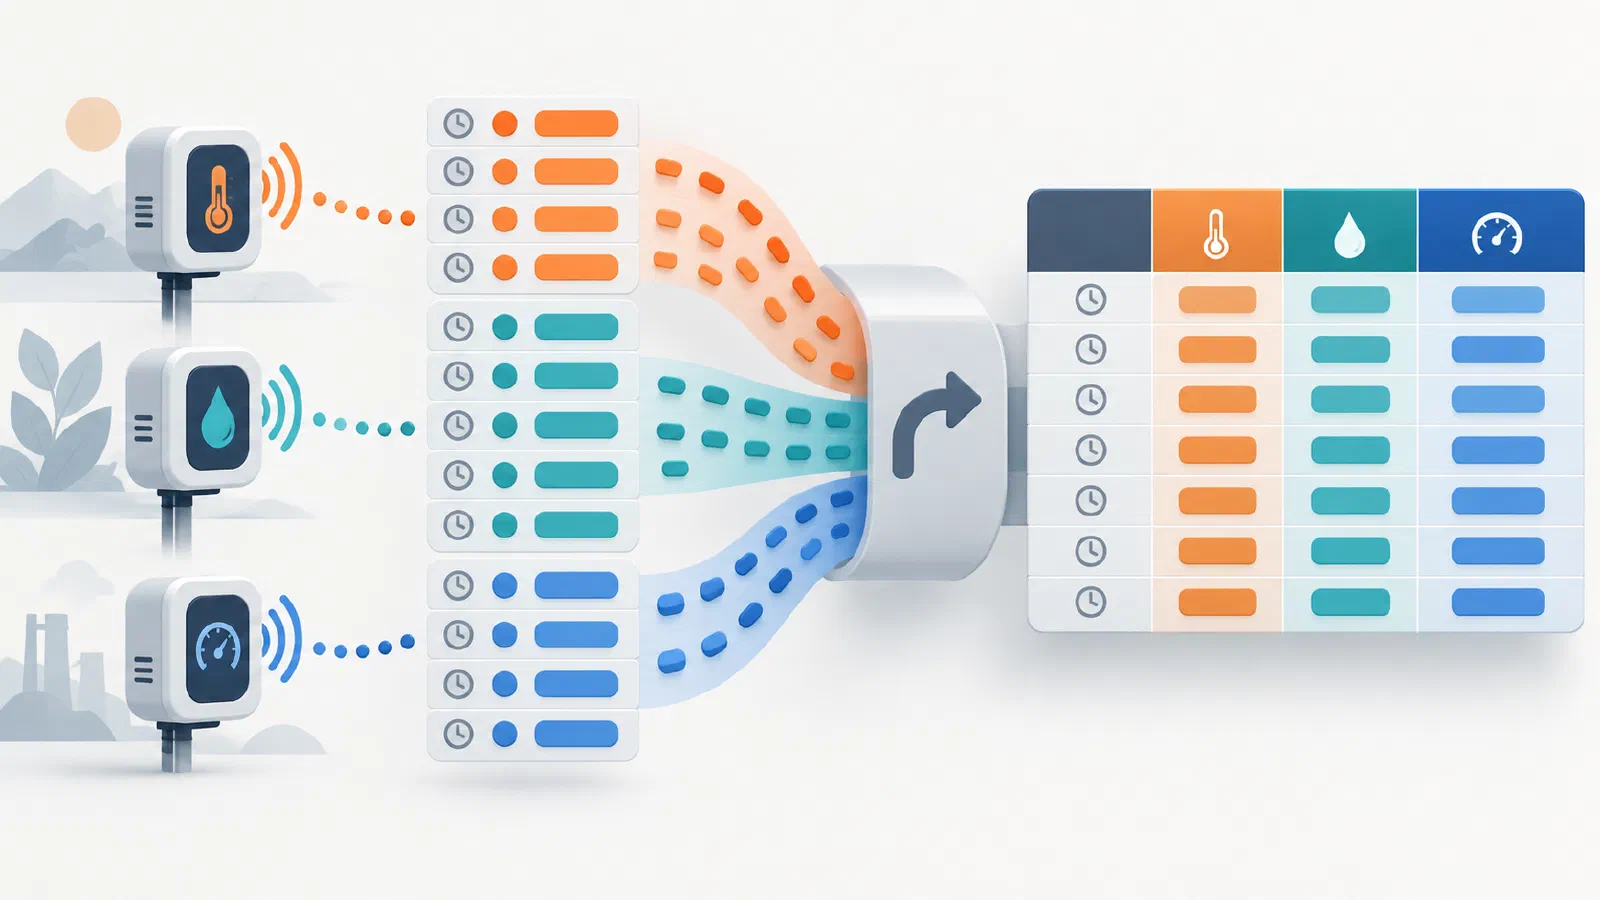
Imagina que recibes lecturas de sensores cada cinco minutos. Cada mensaje contiene un instante, el sensor que lo envió, el nombre de una métrica y su valor. Guardar los mensajes tal como llegan es cómodo: si mañana aparece una métrica nueva, basta con recibir más filas. Pero el informe que consume esos datos pide otra cosa: una fila por instante y sensor, con temperatura, humedad y presión en columnas separadas.
Ese paso de filas a columnas es pivotar los datos. Es habitual en ingeniería de datos y en series temporales: el formato largo facilita la ingesta de eventos y el formato ancho sirve para ciertos informes, exportaciones, modelos y consumidores que esperan un conjunto fijo de variables por observación.
De lecturas a una tabla de ejemplo
En el formato largo, cada fila representa una lectura. Usaremos observed_at para el timestamp, sensor_id para el dispositivo, metric para el tipo de medida y metric_value para el valor. En este ejemplo interpretamos los instantes como UTC y los valores como grados Celsius, porcentaje de humedad y hectopascales, según la métrica. El tipo DATETIME2 por sí solo no registra la zona horaria.
Puedes reproducir el ejemplo en SQL Server con estas doce filas:
CREATE TABLE sensor_readings (
    observed_at  DATETIME2(0) NOT NULL,
    sensor_id    VARCHAR(16) NOT NULL,
    metric       VARCHAR(20) NOT NULL,
    metric_value DECIMAL(8,2) NOT NULL
);

INSERT INTO sensor_readings
    (observed_at, sensor_id, metric, metric_value)
VALUES
    ('2026-09-25T10:00:00', 'S-01', 'temperature', 20.00),
    ('2026-09-25T10:00:00', 'S-01', 'temperature', 22.00),
    ('2026-09-25T10:00:00', 'S-01', 'humidity',    45.00),
    ('2026-09-25T10:00:00', 'S-01', 'pressure',  1012.00),
    ('2026-09-25T10:00:00', 'S-02', 'temperature', 19.00),
    ('2026-09-25T10:00:00', 'S-02', 'humidity',    50.00),
    ('2026-09-25T10:00:00', 'S-02', 'pressure',  1011.00),
    ('2026-09-25T10:05:00', 'S-01', 'temperature', 21.50),
    ('2026-09-25T10:05:00', 'S-01', 'humidity',    44.00),
    ('2026-09-25T10:05:00', 'S-01', 'pressure',  1012.50),
    ('2026-09-25T10:05:00', 'S-02', 'temperature', 19.50),
    ('2026-09-25T10:05:00', 'S-02', 'pressure',  1011.50);
La tabla no impone una clave única sobre instante, sensor y métrica: queremos conservar dos temperaturas para S-01 a las 10:00 y decidir explícitamente qué hacer con ellas. En un sistema real también habría que distinguir una segunda medición de un mensaje retransmitido.
Veamos primero los datos tal como están almacenados:
SELECT observed_at, sensor_id, metric, metric_value
FROM sensor_readings
ORDER BY observed_at, sensor_id, metric, metric_value;
Encontrarás dos filas temperature para S-01 a las 10:00, y ninguna fila humidity para S-02 a las 10:05. Esa ausencia no equivale a una lectura de humedad igual a cero.
El resultado que necesitamos
Antes de escribir la consulta, hay que fijar su granularidad: cada fila del resultado representará una combinación de observed_at y sensor_id. Queremos obtener esto (valores mostrados con dos decimales):
| observed_at | sensor_id | temperature | humidity | pressure |
|---|---|---|---|---|
| 2026-09-25 10:00:00 | S-01 | 21.00 | 45.00 | 1012.00 |
| 2026-09-25 10:00:00 | S-02 | 19.00 | 50.00 | 1011.00 |
| 2026-09-25 10:05:00 | S-01 | 21.50 | 44.00 | 1012.50 |
| 2026-09-25 10:05:00 | S-02 | 19.50 | NULL | 1011.50 |
El 21.00 procede de la media de 20.00 y 22.00. El NULL indica que no hay humedad registrada para esa combinación de instante y sensor. El motor puede mostrar más decimales en los resultados de AVG; la tabla anterior solo facilita la lectura.
Resolverlo con PIVOT en SQL Server
SQL Server ofrece el operador PIVOT para convertir valores de una columna en columnas del resultado mientras agrega las lecturas correspondientes:
SELECT
    observed_at,
    sensor_id,
    [temperature],
    [humidity],
    [pressure]
FROM (
    SELECT observed_at, sensor_id, metric, metric_value
    FROM sensor_readings
) AS readings
PIVOT (
    AVG(metric_value)
    FOR metric IN ([temperature], [humidity], [pressure])
) AS wide_readings
ORDER BY observed_at, sensor_id;
Se lee de dentro hacia fuera:
- La subconsulta
readingsentrega solo las dos dimensiones, la métrica y su valor. FOR metricindica que los valores demetricse convertirán en encabezados.IN (...)enumera las columnas que queremos crear. Los corchetes son la forma de delimitar identificadores en T-SQL; la lista no se descubre automáticamente.AVG(metric_value)decide qué valor colocar en cada celda si llegan varias lecturas para la misma métrica, instante y sensor.wide_readingses el alias obligatorio de la tabla resultante; elORDER BYpresenta las filas en orden temporal.
La subconsulta también protege la granularidad. SQL Server agrupa por las columnas de entrada que no son ni la columna pivotada ni la agregada. Si pasáramos además un identificador de evento o una fecha de ingesta, podríamos obtener varias filas para el mismo instante y sensor. Si, por el contrario, quitáramos sensor_id, mezclaríamos las lecturas de ambos sensores.
La agregación no es un adorno sintáctico: el motor necesita una regla para reducir varias filas a una celda. Aquí elegimos la media para mostrarlo, pero esa decisión depende del significado de las mediciones. Si las dos temperaturas fueran retransmisiones del mismo evento, habría que deduplicar antes; si interesa la lectura más reciente, necesitaríamos una marca temporal o un identificador adicional y una regla para escogerla. En ninguno de esos casos AVG sería automáticamente la operación adecuada.
La misma transformación con CASE y GROUP BY
Podemos expresar la misma idea con agregación condicional, sin PIVOT:
SELECT
    observed_at,
    sensor_id,
    AVG(CASE WHEN metric = 'temperature' THEN metric_value END) AS temperature,
    AVG(CASE WHEN metric = 'humidity'    THEN metric_value END) AS humidity,
    AVG(CASE WHEN metric = 'pressure'    THEN metric_value END) AS pressure
FROM sensor_readings
GROUP BY observed_at, sensor_id
ORDER BY observed_at, sensor_id;
GROUP BY forma una fila por instante y sensor. Cada CASE deja pasar solo los valores de una métrica y devuelve NULL para las demás; AVG ignora esos NULL. Para S-01 a las 10:00 calcula la media de las dos temperaturas. Para la humedad ausente de S-02 a las 10:05 no encuentra ningún valor y devuelve NULL. Es una alternativa útil cuando queremos ver la lógica de cada columna de forma explícita o escribir SQL portable.
¿Y en MySQL?
MySQL no incorpora el operador PIVOT de T-SQL. Podemos crear la misma tabla cambiando el tipo temporal y reutilizando el INSERT anterior; el formato de fecha con T también es válido para MySQL:
CREATE TABLE sensor_readings (
    observed_at  DATETIME NOT NULL,
    sensor_id    VARCHAR(16) NOT NULL,
    metric       VARCHAR(20) NOT NULL,
    metric_value DECIMAL(8,2) NOT NULL
);
La consulta es la agregación condicional que acabamos de ver:
SELECT
    observed_at,
    sensor_id,
    AVG(CASE WHEN metric = 'temperature' THEN metric_value END) AS temperature,
    AVG(CASE WHEN metric = 'humidity'    THEN metric_value END) AS humidity,
    AVG(CASE WHEN metric = 'pressure'    THEN metric_value END) AS pressure
FROM sensor_readings
GROUP BY observed_at, sensor_id
ORDER BY observed_at, sensor_id;
En MySQL, CASE WHEN sin ELSE devuelve NULL cuando no se cumple la condición, y AVG ignora los valores nulos. Por eso produce el mismo resultado lógico. La sintaxis concreta de las fechas y el tipo de columna cambian entre motores, pero la idea de agrupar dimensiones y calcular cada métrica por separado se mantiene.
Cuando las métricas cambian
Este es un pivot estático: hemos escrito temperature, humidity y pressure en la consulta. Si llega battery_level, no aparecerá como columna hasta que cambiemos el SQL. Lo mismo sucede con la solución mediante CASE: cada columna nueva requiere una expresión nueva.
Cuando las métricas no se conocen de antemano, se puede construir la lista de columnas y la consulta mediante SQL dinámico: dynamic pivot. En SQL Server eso exige tratar con cuidado los identificadores y los valores de entrada. Merece un artículo aparte. Además, un esquema de salida que cambia en cada ejecución puede complicar a los consumidores; a veces es preferible conservar el formato largo.
UNPIVOT es la operación relacionada que lleva columnas de vuelta a filas. No deshace exactamente este ejemplo: el promedio 21.00 ya no conserva por separado las lecturas 20.00 y 22.00, y los NULL pueden desaparecer al despivotar.
¿En la base de datos o fuera de ella?
Un pipeline puede recibir telemetría en formato largo, almacenarla así y entregar una vista ancha a un informe o a un consumidor concreto. Si los datos ya están en SQL Server o MySQL, resolver esa transformación en el motor puede evitar extraer muchas filas, transferirlas, reconstruir la tabla en Python y volver a escribirla. Conocer bien SQL permite tomar esa decisión, en vez de recurrir automáticamente a un script.
Eso no significa que el SQL sea siempre más rápido. Importan el volumen, los índices, el plan de consulta, la memoria disponible, la arquitectura del pipeline y la complejidad de la transformación. Para una regla de negocio difícil de expresar o para datos que ya se procesan fuera de la base, otra herramienta puede encajar mejor. Lo esencial es decidir primero qué representa una fila y cómo se resuelven las lecturas repetidas; después viene la elección del operador.