
Mantener lo que nos sostiene: infraestructuras críticas y software
Anoche, 13 de noviembre de 2026, la FAA ordenó suspender los despegues a escala nacional en Estados Unidos. El tráfico aéreo quedó condicionado por un fallo en la infraestructura que permite coordinarlo. La comunicación de la Autoridad de Turismo de Hawái recoge la orden y su posterior levantamiento: se trató de detener salidas, mientras los vuelos internacionales entrantes se gestionaban caso por caso.
El secretario de Transportes, Sean Duffy, describió un sistema de control aéreo muy antiguo. Atribuyó la interrupción a equipos de comunicaciones, conmutadores y routers que se habían sobrecargado y proporcionaban datos inconsistentes. El comunicado del Departamento de Transportes recoge esa explicación y la reapertura del espacio aéreo. Es la versión oficial inicial, no un análisis técnico definitivo de la causa raíz.

La antigüedad de esos sistemas ya estaba documentada. En septiembre de 2024, la Government Accountability Office —GAO— publicó que la FAA había clasificado 51 de sus 138 sistemas de control aéreo como insostenibles, por problemas que incluían funcionalidad obsoleta y falta de repuestos.
Me cuesta leer estas noticias sin pensar en lo poco que valoramos el trabajo que evita que algo ocurra. Una infraestructura bien mantenida suele ofrecer un resultado discreto: el tren llega, el avión despega, el hospital atiende, la aplicación responde. Otro día normal.
Y precisamente porque parece normal, resulta tentador considerar prescindible el dinero que lo hace posible.
Urda y Adamuz: exigir explicaciones sin dar por cerradas las causas
La conexión con los accidentes de Urda y Adamuz es inmediata en mi cabeza. También obliga a ser riguroso: relacionar estas noticias con la conservación de las infraestructuras no permite atribuir a todos los sucesos una misma causa.
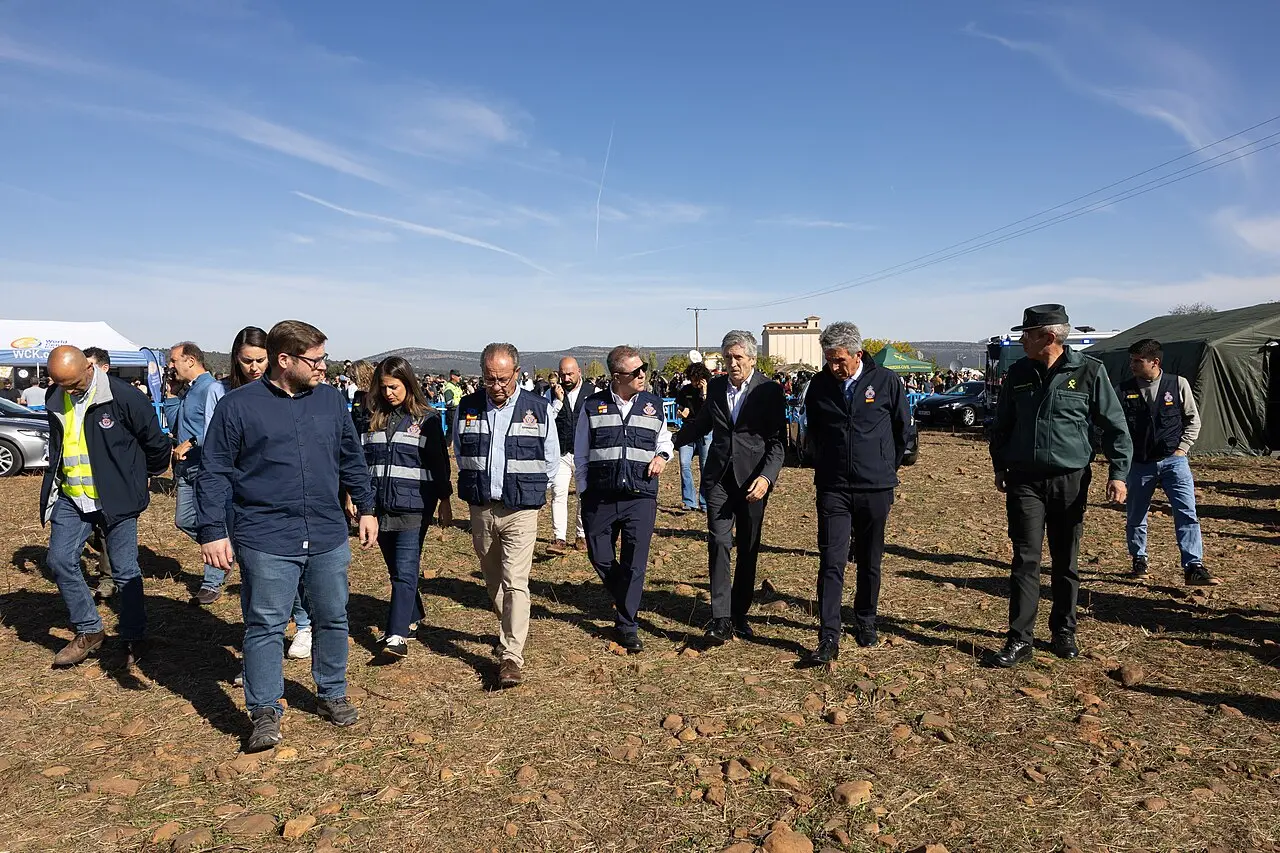
En Urda, el 28 de octubre de 2026, un AVE alcanzó a un Iryo detenido. La reconstrucción publicada por RTVE sitúa entre los elementos investigados una avería informática que dejó fuera de servicio el LZB, la circulación en situación degradada y las órdenes intercambiadas entre el centro de control y los maquinistas. Había versiones contradictorias; la investigación seguía abierta.

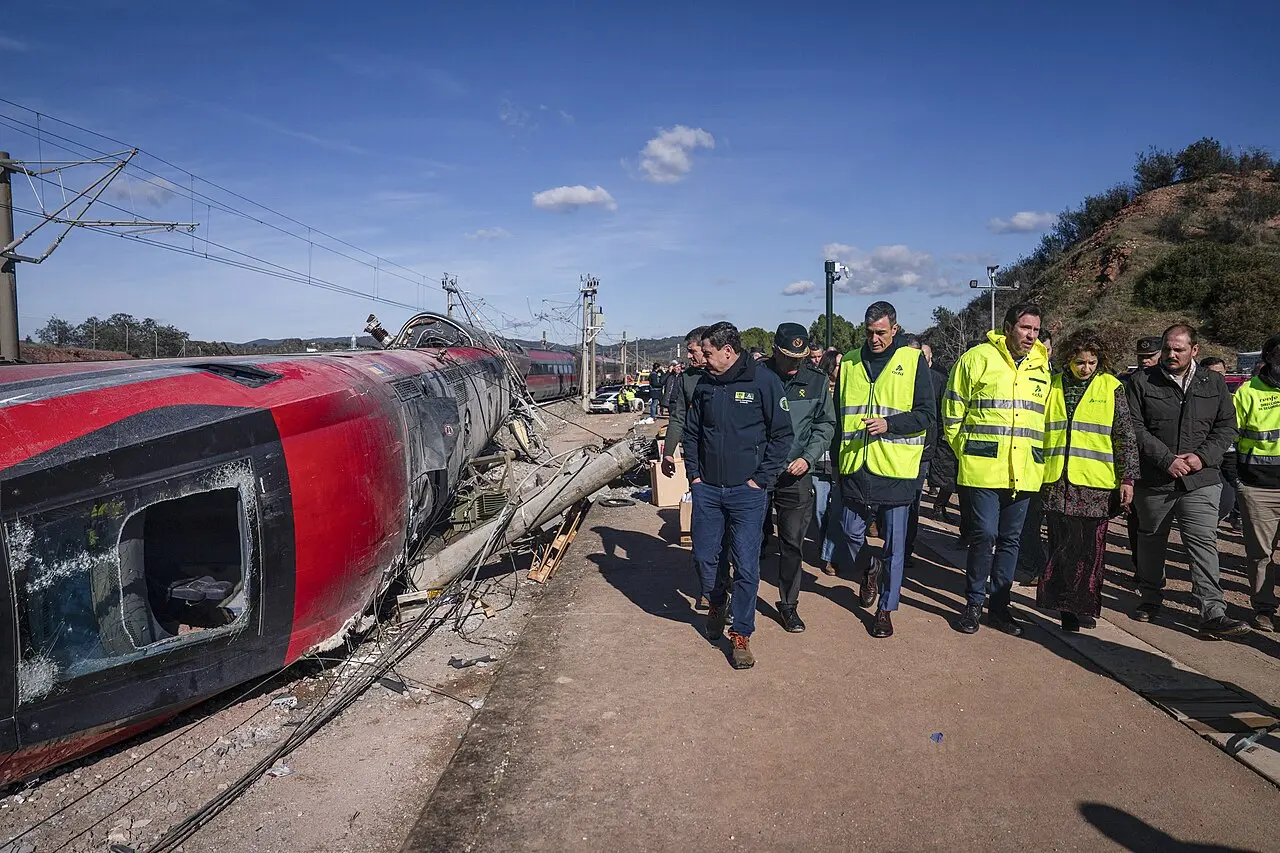
En Adamuz, donde el accidente ocurrió el 18 de enero de 2026, las pesquisas se han centrado en la rotura del carril o su soldadura. EFE explicaba el 5 de noviembre que continuaban las diligencias y los requerimientos de documentación sobre renovación y mantenimiento. Ese foco de investigación no equivale a una conclusión definitiva sobre el origen de la rotura ni sobre las responsabilidades.

Mi preocupación común es otra: qué garantías tenemos de que las infraestructuras conservan sus condiciones de seguridad durante toda su vida útil, y qué ocurre cuando una de sus protecciones deja de funcionar.
En la aviación estadounidense, detener los despegues fue una respuesta de seguridad ante una pérdida de confianza en el sistema. Ese aspecto también merece atención. Una organización debe poder reducir su actividad o pararla cuando no puede garantizar las condiciones necesarias para continuar. La presión por mantener el servicio necesita límites claros, procedimientos practicables y personas con autoridad para aplicarlos.
El mantenimiento también necesita una decisión política y empresarial
Construir algo nuevo permite anunciar una inauguración. Mantener lo existente exige explicar por qué hay que gastar dinero para que mañana sigamos teniendo lo que hoy damos por supuesto.
En una empresa de software ocurre algo parecido. Una función nueva se enseña en una presentación. Una biblioteca actualizada, una restauración de datos ensayada o la eliminación de una dependencia peligrosa apenas se ven desde fuera.
Eso crea un incentivo que me parece preocupante: aplazar el trabajo cuyo beneficio resulta difícil de mostrar. Si el sistema sigue funcionando, la siguiente prórroga parece justificable. El riesgo acumulado queda fuera de la conversación hasta que se convierte en una interrupción, una pérdida o una tragedia.
La relación entre mantenimiento y seguridad, sin embargo, cuenta con antecedentes investigados. No hace falta anticipar las conclusiones de los accidentes recientes para defenderla.
Tres antecedentes en infraestructuras físicas
Mianus River, 1983: una inspección que no detecta el deterioro
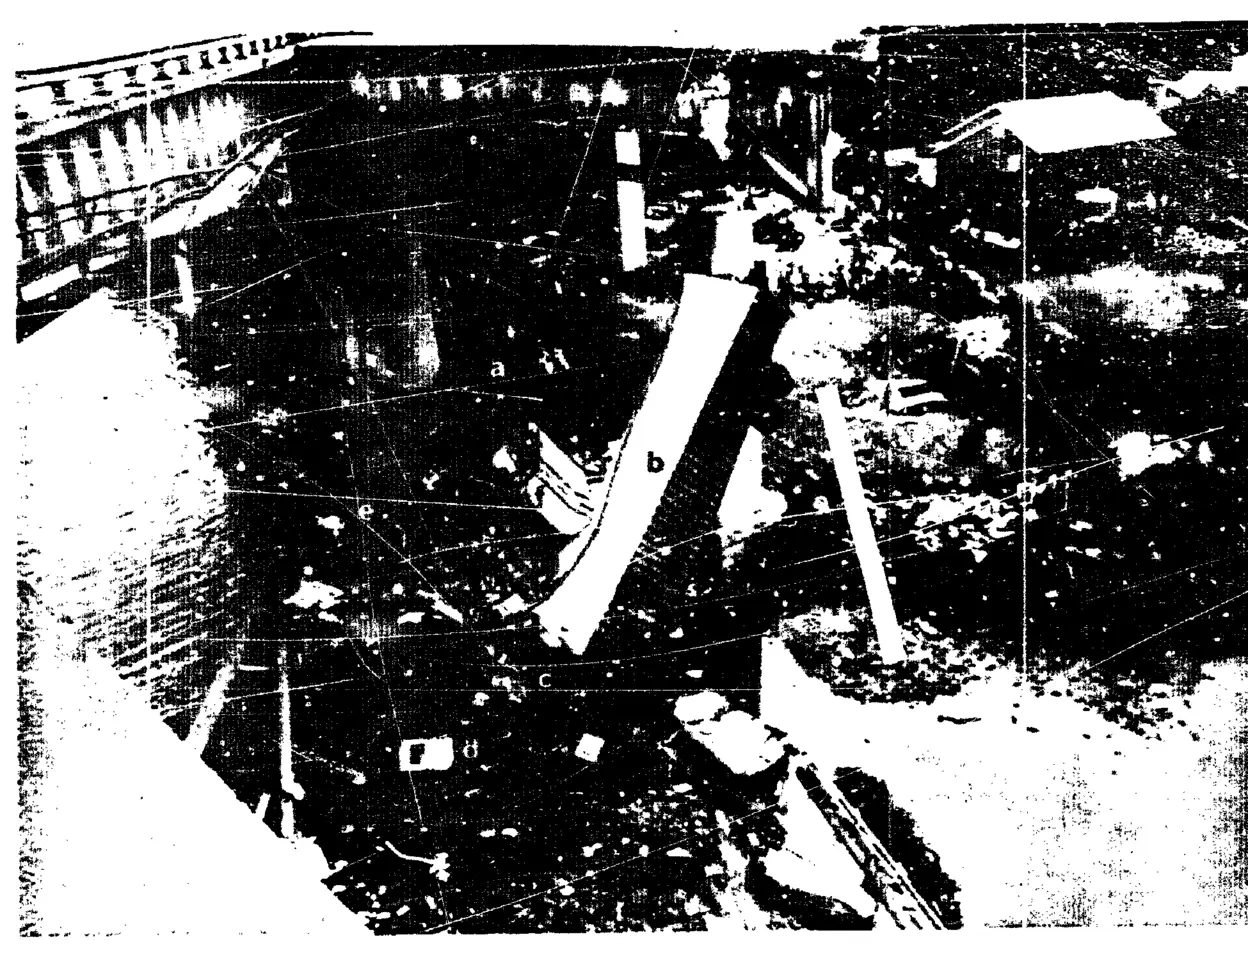
El 28 de junio de 1983 se desplomó un tramo del puente de la I-95 sobre el río Mianus, en Connecticut. Murieron tres personas. La NTSB atribuyó la causa probable al desplazamiento no detectado de elementos del conjunto de suspensión, provocado por fuerzas asociadas a la corrosión, y lo relacionó con deficiencias del programa de inspección y mantenimiento del estado.
Una inspección necesita medios y métodos que permitan conocer el estado real de las piezas relevantes. Su mera existencia administrativa no garantiza que cumpla esa función. En software deberíamos recordar esto cada vez que una auditoría se da por satisfecha con comprobar que existe un procedimiento.
Hatfield, 2000: conocer un problema exige resolverlo

En el descarrilamiento de Hatfield, del 17 de octubre de 2000, el carril se fracturó por defectos de fatiga. El informe del Railway Safety & Standards Board, conservado en The Railways Archive, identificó fallos en las inspecciones, en la gestión de los contratos de mantenimiento y renovación, y en la ejecución de una sustitución urgente del carril que no llegó a completarse.
Aquí la analogía con una vulnerabilidad conocida resulta difícil de ignorar. Registrar un defecto es el principio del trabajo. Para reducir el riesgo hacen falta una actuación, un responsable, un plazo y una comprobación posterior. Un problema puede estar perfectamente documentado y seguir siendo peligroso.
Fern Hollow, 2022: recomendaciones que se repiten sin ejecutarse
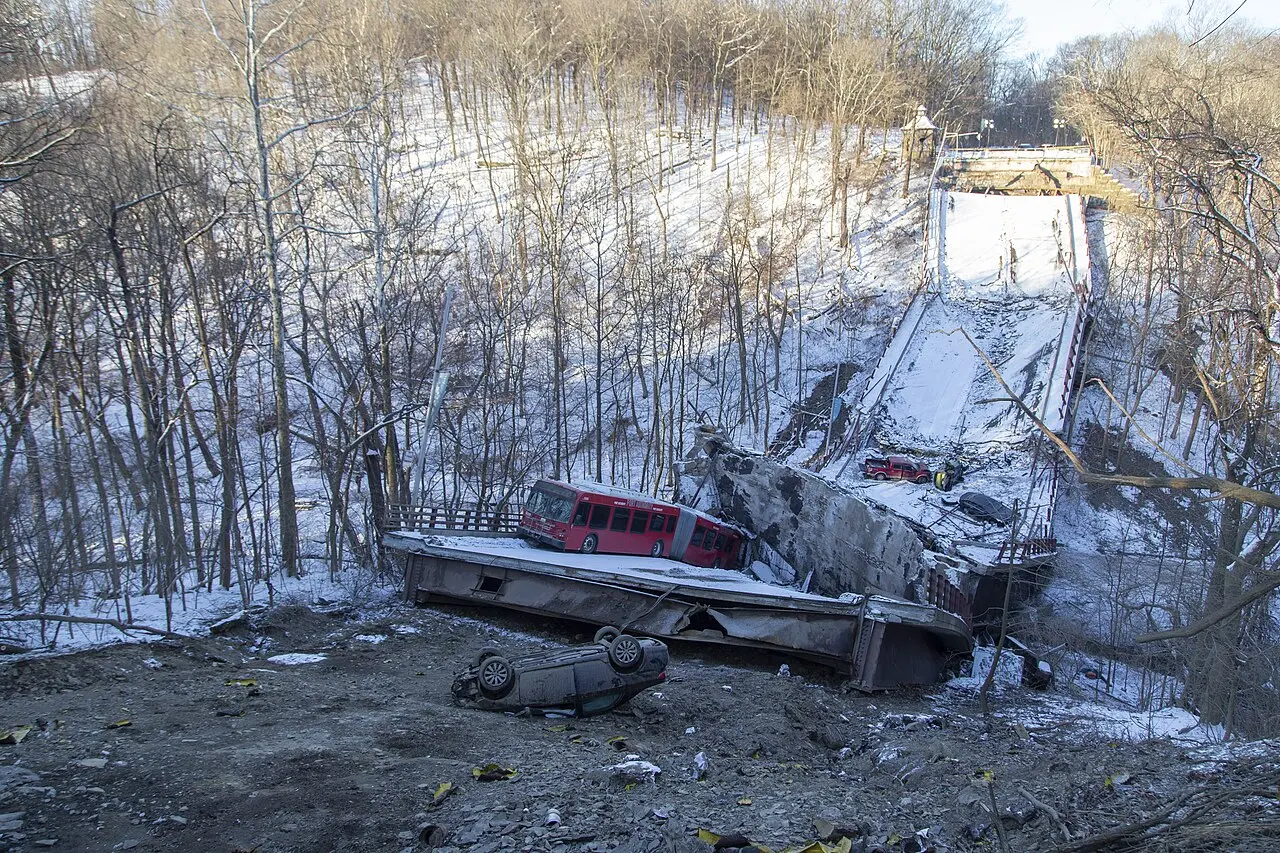

El puente de Fern Hollow, en Pittsburgh, colapsó el 28 de enero de 2022. La investigación de la NTSB relacionó el fallo con corrosión y pérdida de sección en un elemento estructural crítico. Los drenajes obstruidos favorecieron la acumulación de agua y residuos. La ciudad no había actuado sobre recomendaciones reiteradas de mantenimiento y reparación; también contribuyeron deficiencias de inspección y supervisión.
Pienso en los avisos que reaparecen en cada revisión de un sistema informático. Una alerta repetida puede acabar formando parte del paisaje. Por eso importa comprobar qué recomendaciones se han ejecutado y qué evidencia permite cerrarlas. Que el último informe contenga la misma observación que el anterior debería provocar una decisión.
El software también necesita conservación
El código no se oxida como una pieza de acero. La comparación tiene ese límite y conviene conservarlo.
Pero el servicio que depende de ese código cambia de contexto: aparecen vulnerabilidades, crece la carga, se sustituyen equipos, cambian las interfaces, caducan certificados y los fabricantes terminan el soporte. También se van las personas que conocen los motivos de determinadas decisiones.
Un programa puede conservar exactamente los mismos bytes y resultar cada vez más difícil de operar con seguridad. Por eso, mantenerlo incluye sus dependencias, los datos, la infraestructura, los procedimientos y el conocimiento del equipo.
La deuda técnica describe parte de ese trabajo pendiente. Para gestionarla hay que concretarla: qué componente supone un riesgo, qué consecuencias tendría su fallo, quién puede intervenir y cuánto tiempo necesitamos para sustituirlo o recuperarlo. La expresión pierde utilidad cuando se convierte en una etiqueta genérica que permite posponerlo todo.
Cinco incidentes que ayudan a entenderlo
WannaCry y el NHS, 2017: una corrección disponible que no llega a los equipos

Según la National Audit Office, los organismos del NHS infectados por WannaCry tenían sistemas Windows sin parchear o sin soporte. Se habían emitido avisos para aplicar correcciones, pero faltaba un mecanismo formal para comprobar su cumplimiento. El ataque interrumpió servicios sanitarios y obligó a cancelar miles de citas y operaciones.
Mi lectura es que publicar una instrucción deja todavía mucho trabajo operativo: inventariar los equipos, comprobar compatibilidades, planificar la intervención y verificar el resultado. Eso requiere personal y tiempo reservado. La seguridad depende también de que la organización haga posible el mantenimiento que exige.
Equifax, 2017: una vulnerabilidad y una vigilancia que tampoco funcionaba

El informe GAO-18-559 describe una vulnerabilidad de Apache Struts que no se corrigió en el portal afectado por la intrusión de Equifax. Una lista de destinatarios desactualizada impidió que el aviso llegara a quienes debían instalar el parche. Además, un certificado caducado impedía inspeccionar tráfico cifrado, dificultando detectar la extracción de datos.
El ejemplo amplía lo que entiendo por mantenimiento: también hay que conservar el inventario, los canales de aviso y los propios mecanismos de vigilancia. Podemos tener una herramienta de seguridad desplegada y haber perdido la capacidad que creíamos que nos proporcionaba.
Knight Capital, 2012: el código que dejamos atrás sigue ahí

El 1 de agosto de 2012, un despliegue incorrecto activó una función defectuosa que Knight Capital conservaba en su sistema de encaminamiento de órdenes. La SEC documentó controles insuficientes de despliegue y pruebas. La empresa acumuló posiciones no deseadas y perdió más de 460 millones de dólares en unos 45 minutos.
Retirar código que ya no debería utilizarse es una forma de mantenimiento. También lo es conocer qué versión ejecuta cada servidor y disponer de controles que limiten el daño. Actualizar una parte del sistema exige comprender cómo interactúa con las demás.
GitLab, 2017: la recuperación también tiene que mantenerse
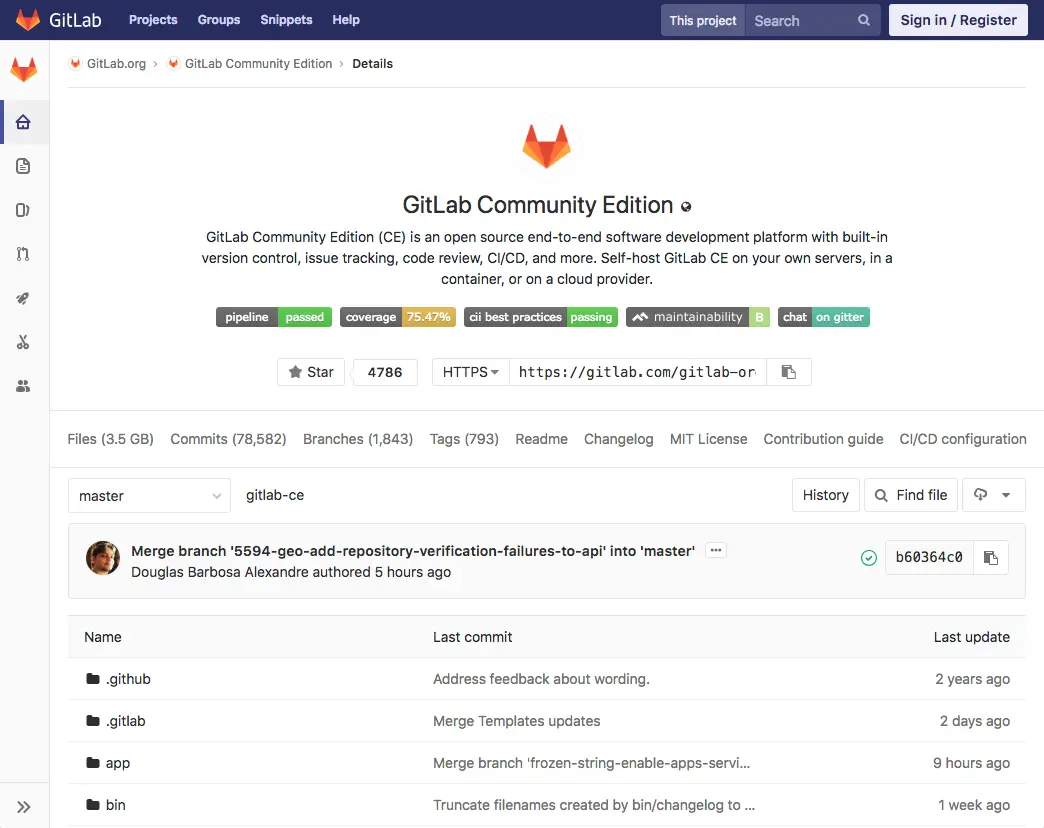

Tras el borrado accidental de datos de producción del 31 de enero de 2017, GitLab descubrió problemas en sus mecanismos de recuperación. Su análisis posterior explica que las copias lógicas fallaban por una incompatibilidad de versiones de PostgreSQL y que los correos de error eran rechazados. No había una persona responsable de probar regularmente ese procedimiento. La recuperación utilizó una instantánea anterior y se perdió parte de los datos recientes de la base de datos.
Tener una tarea llamada «backup» aporta una garantía muy limitada. Lo que necesitamos saber es si podemos restaurar, qué perderíamos y cuánto tardaríamos. Las pruebas periódicas permiten comprobarlo antes de depender de esa respuesta durante una crisis.
La FAA, 2023: una intervención puede afectar también al respaldo
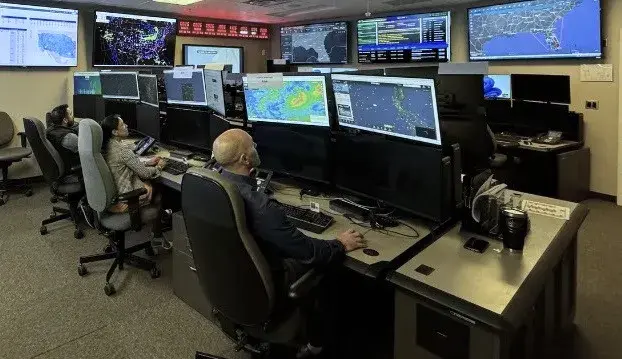
El episodio de anoche tiene un antecedente distinto en enero de 2023. La FAA informó entonces de que personal contratado había borrado archivos involuntariamente mientras corregía la sincronización entre las bases de datos principal y de respaldo del sistema NOTAM. La interrupción también llevó a detener despegues.
Mi lectura de aquel incidente es que dos sistemas necesitan una separación efectiva de sus modos de fallo. Una réplica y una copia recuperable cumplen funciones diferentes. Diseñar y ensayar cómo sobrevivir a una operación equivocada forma parte del trabajo de mantener un servicio crítico.
Las analogías sirven para decidir qué hacer
Estas correspondencias son una forma de interpretar los casos, no una afirmación de que compartan idénticas causas o consecuencias:
| En una infraestructura física | En un sistema de software | Trabajo que debemos financiar |
|---|---|---|
| Deterioro que la inspección no detecta | Vulnerabilidades o fallos que la supervisión no ve | Revisar y comprobar los mecanismos de inspección |
| Reparación urgente que se aplaza | Corrección conocida que nunca llega a producción | Asignar responsable, plazo y verificación |
| Elemento de protección fuera de servicio | Respaldo, alarma o restauración inoperantes | Ensayar las protecciones y la recuperación |
| Aumento de tráfico sobre una capacidad limitada | Más usuarios, datos o integraciones | Medir márgenes y ampliar capacidad a tiempo |
| Conocimiento técnico que se pierde | Un sistema que solo comprende una persona | Documentar, formar y asegurar continuidad del equipo |
La comparación tampoco equipara una caída de una aplicación con la pérdida de vidas en un accidente. Las consecuencias dependen del servicio. Precisamente por eso hay que identificar qué software participa en funciones críticas y tratarlo con el rigor correspondiente.
Modernizar requiere controlar el cambio
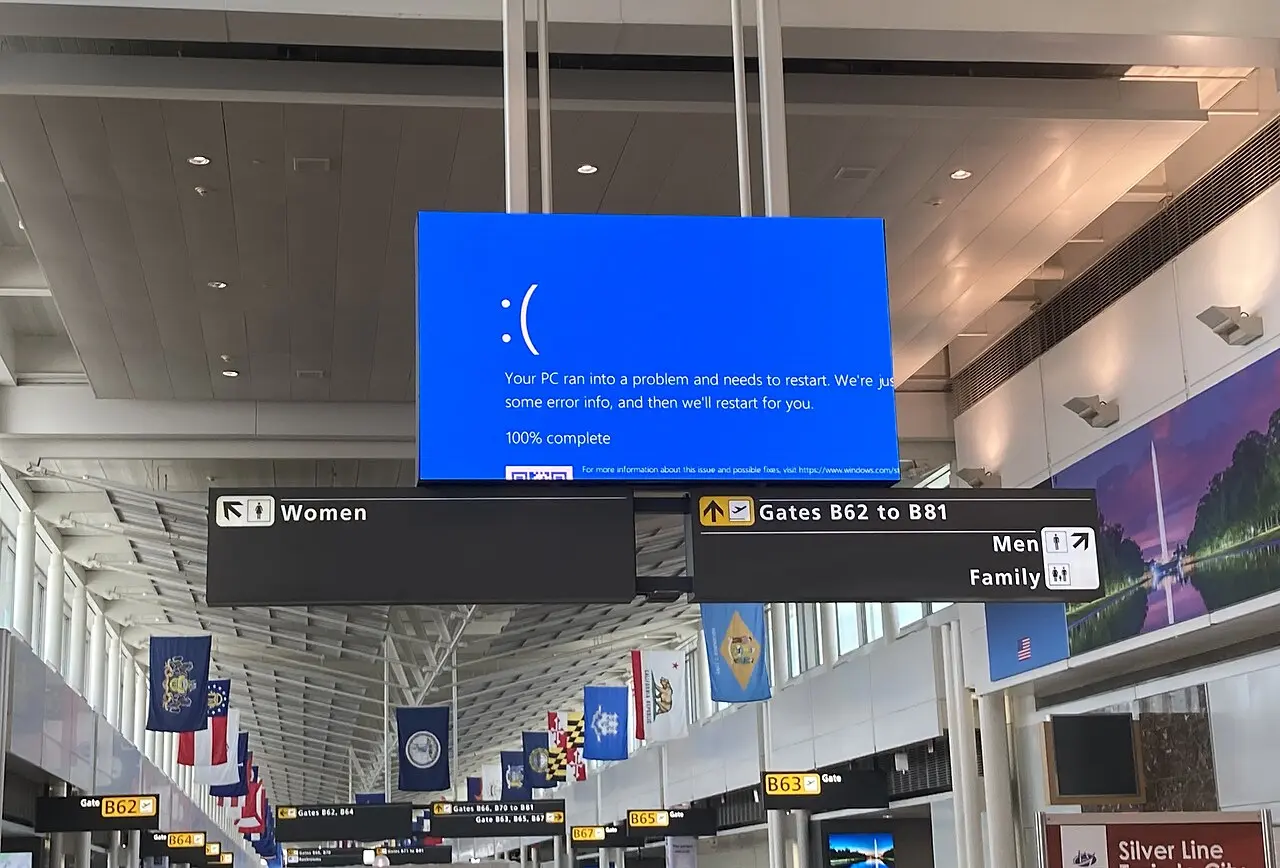

Defender la inversión en mantenimiento no significa recomendar actualizaciones indiscriminadas. El 19 de julio de 2024, una actualización de contenido de CrowdStrike provocó fallos en sistemas Windows. Su análisis de causa raíz describe una incompatibilidad entre los campos de entrada esperados y los suministrados. Entre las medidas posteriores incluyó más comprobaciones y despliegues por fases.
Ese caso muestra por qué el presupuesto de modernización debe cubrir también las pruebas, la transición y la recuperación. Hay que evaluar tanto el riesgo de conservar un componente como el de modificarlo. Un sistema antiguo bien conocido puede justificar una sustitución gradual; un componente sin soporte o sin repuestos puede exigir actuar con más urgencia.
La decisión necesita información sobre el servicio y sus riesgos. La edad, por sí sola, no permite determinar la seguridad de un sistema. Tampoco la palabra «nuevo» garantiza que lo hayamos integrado correctamente.
Invertir de forma que podamos comprobar el resultado
Si tuviera que pedir un compromiso a quienes dirigen una infraestructura o un producto de software, empezaría por algo concreto:
- Presupuesto durante toda la vida útil. La compra o la construcción deben incluir una previsión de conservación, renovación y retirada.
- Un inventario con responsables. Qué tenemos, de qué depende, qué soporte conserva y quién responde por ello.
- Tiempo de intervención. Ventanas para inspeccionar, corregir y probar, con recursos para resolver incompatibilidades.
- Seguimiento de los defectos. Priorizar por consecuencias, registrar aplazamientos y comprobar la reparación antes de cerrar el aviso.
- Recuperación demostrada. Restaurar copias y ensayar alternativas con objetivos de tiempo y pérdida de datos adecuados al servicio.
- Personas que puedan sostener el sistema. Formación, documentación y continuidad del conocimiento.
- Capacidad para detenerse. Criterios claros para reducir o suspender la actividad cuando las condiciones de seguridad lo requieran.
Podemos revisar cuánto tardamos en corregir los defectos importantes, cuándo se probó por última vez una restauración o qué componentes se acercan al final de su soporte. Esas respuestas ayudan a decidir dónde invertir y permiten comprobar si el dinero está reduciendo riesgos.
No todo fallo demuestra una falta de mantenimiento, ni toda inversión evita cualquier accidente. Aun así, los casos investigados ofrecen razones suficientes para tomarse en serio ese trabajo y exigir que se haga bien.
Quiero poder confiar en las infraestructuras que utilizo. Y esa confianza necesita algo más que la promesa de que ayer funcionaron: necesita personas, presupuesto, inspecciones útiles y problemas que se resuelvan.
Mantener es parte de construir algo que merezca seguir funcionando. Lo que sostendrá el servicio dentro de diez años también debería formar parte de las decisiones que tomamos hoy.
Información contrastada hasta el 14 de noviembre de 2026. Las referencias a Urda y Adamuz describen investigaciones abiertas; las analogías y las propuestas de inversión son la reflexión del artículo.
Las fotografías y la captura de interfaz se han redimensionado y convertido a WebP. La imagen de Mianus se ha recortado de la página del informe para aislar la fotografía, conservando sus anotaciones. Cada archivo conserva la licencia indicada en su pie; las imágenes de contexto se identifican expresamente.