
La migración que nadie escribió: ADN antiguo y la transformación de Iberia
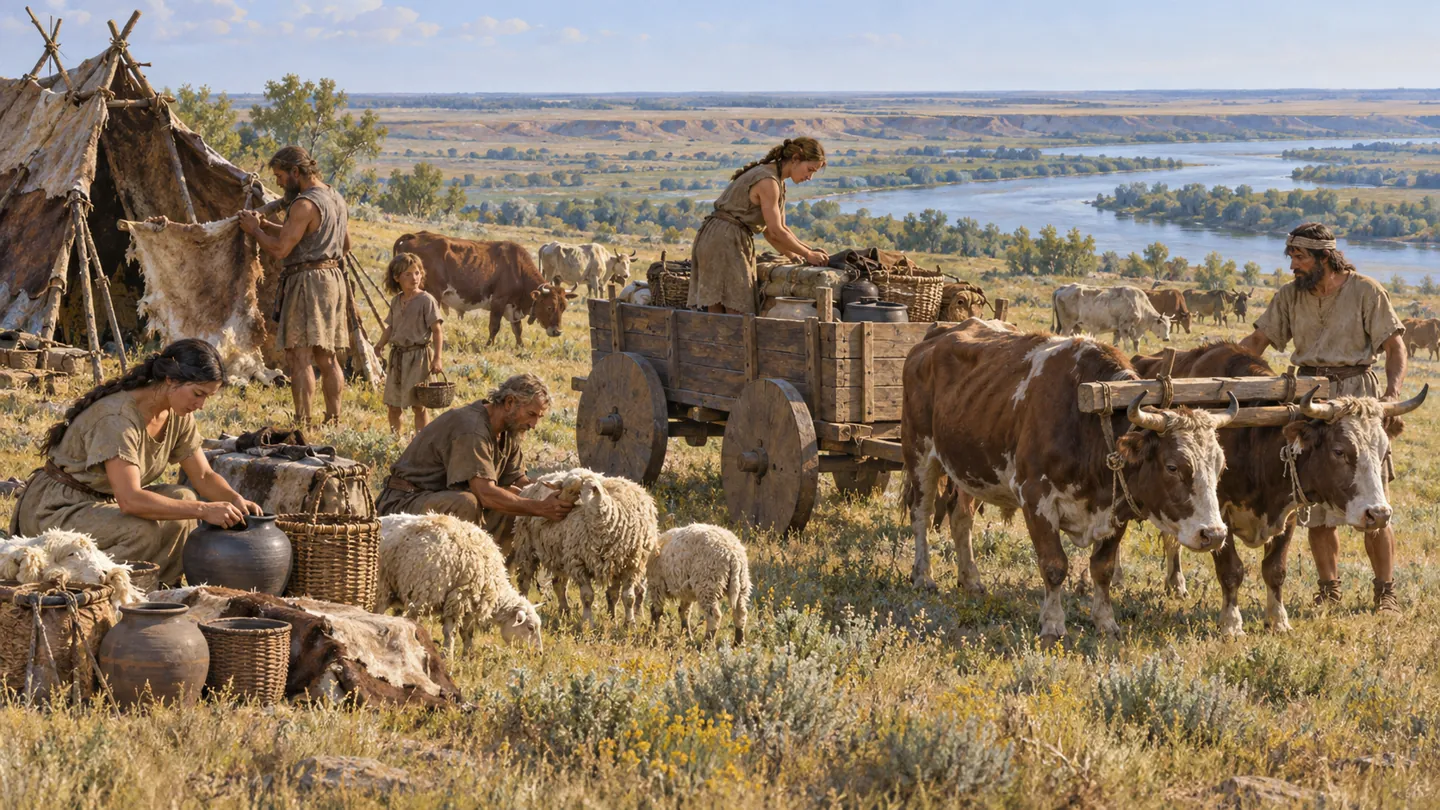
Reconstrucción ilustrativa generada con IA. Región del bajo Don–Volga, hacia 3000 a. C. El pastoreo, los productos lácteos y el transporte en carros tienen respaldo arqueológico y biomolecular; el campamento, las prendas y los rostros son decisiones ilustrativas, no una restitución exacta. Referencias: Wilkin et al., 2021 y estudio sobre ganadería lechera en el Cáucaso y las estepas, 2022.
En Castillejo del Bonete, en Terrinches, Ciudad Real, dos personas fueron enterradas una junto a otra durante la Edad del Bronce. La posición de sus cuerpos no decía dónde habían vivido sus antepasados. El ADN añadió una diferencia invisible: el varón tenía ascendencia relacionada con grupos de Europa central; la mujer encajaba con la población ibérica anterior a esa llegada. Estar juntos en una tumba no permite afirmar, por sí solo, que fueran una pareja ni reconstruir sus biografías. Pero el caso abre una ventana a un mundo en transformación. Lo recoge el trabajo de Olalde y colaboradores de 2019 y lo contextualiza Harvard Medical School.
¿Cómo reconstruimos una migración de hace cinco mil años si nadie dejó escrito quién llegó ni de dónde venía?
No existe un marcador que diga «esta persona era inmigrante». La respuesta requiere unir enterramientos, objetos, fechas y miles de posiciones del genoma. Cada pieza responde a una pregunta distinta. La arqueología sitúa una vida en un lugar y una sociedad; el radiocarbono aproxima cuándo ocurrió; la genética compara relaciones biológicas; la computación hace manejables millones de observaciones fragmentarias.
Conviene mantener cuatro palabras separadas desde el principio. Una cultura arqueológica agrupa regularidades materiales —cerámica, viviendas, formas de enterramiento—. La ascendencia genética describe relaciones de descendencia que estimamos comparando ADN. Una lengua se transmite socialmente y puede cambiar sin que cambie toda la población. La identidad es cómo las personas se reconocen y organizan, algo que no se lee directamente en un hueso. Las cuatro pueden relacionarse; ninguna equivale automáticamente a las otras.
Antes de la estepa: una Europa que ya había cambiado
Los cazadores-recolectores europeos no formaban una población uniforme. El final de las glaciaciones y los milenios posteriores habían producido desplazamientos y diferencias regionales. «Cazador-recolector occidental» es una categoría comparativa útil en genética, no el nombre de un pueblo que viviera intacto desde Portugal hasta Polonia.
En Iberia, las comunidades mesolíticas aprovechaban recursos muy distintos: bosques, costas, ríos y estuarios. Los concheros de Muge, en Portugal, conservan acumulaciones de moluscos consumidos, restos de peces y animales terrestres, útiles líticos, hogares y enterramientos. Esas acumulaciones no eran simplemente basura: registran ocupaciones reiteradas y actividades que pueden estudiarse capa a capa. El portal de investigación de ICArEHB documenta ese paisaje estuarino y la diversidad de su economía.
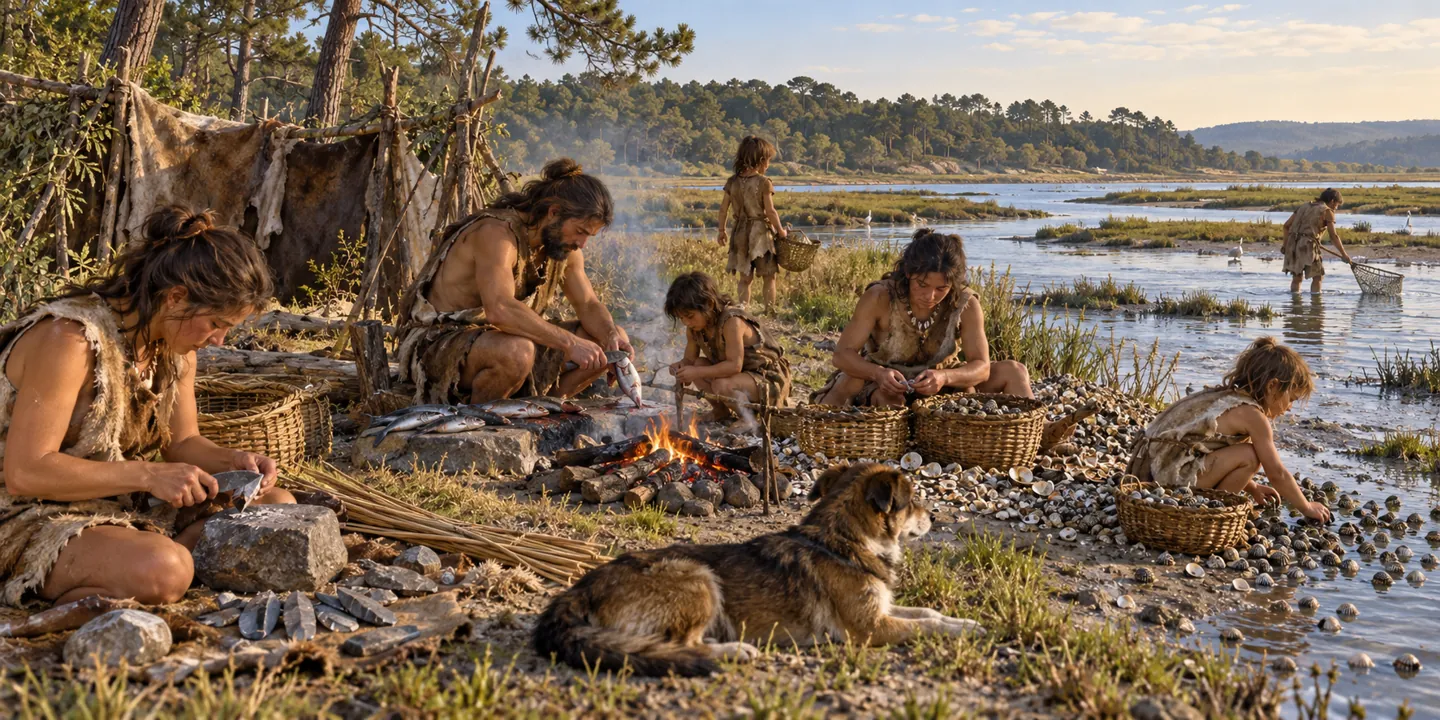
Reconstrucción ilustrativa generada con IA. Valle de Muge y bajo Tajo, hacia 6000 a. C., inspirada en sus concheros mesolíticos. Pesca, marisqueo, hogares, industria lítica y presencia de perros se apoyan en el registro descrito por ICArEHB. La disposición del campamento, la cubierta, las cestas y las prendas son aproximaciones ilustrativas. No representa una costa antigua cartografiada ni una vivienda concreta excavada.
Mucho antes de que apareciera la señal esteparia, la expansión agrícola había transformado Europa. Comunidades relacionadas con los primeros agricultores de Anatolia y el Egeo se extendieron hacia los Balcanes y desde allí por conexiones continentales y mediterráneas. Hacia 5600 a. C. la agricultura estaba establecida tanto en Iberia como en Europa central. El ADN antiguo mostró que aquel proceso incluyó movimientos importantes de personas: no consistió únicamente en que grupos locales copiaran una técnica. El estudio de Mathieson et al. sobre el sureste europeo reconstruye ese contexto.
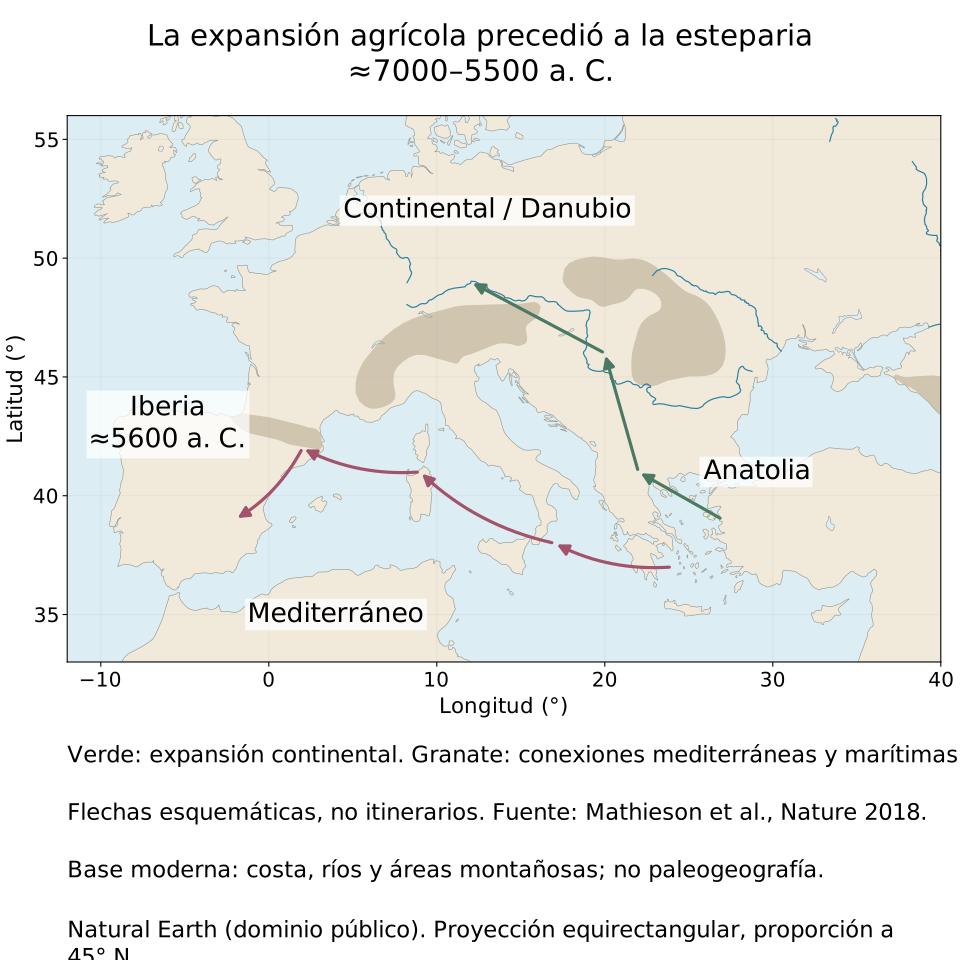
Expansión agrícola, aproximadamente 7000–5500 a. C. Flechas esquemáticas: resumen conexiones, no viajes individuales ni rutas exclusivas. Cartografía moderna de Natural Earth, dominio público; fuentes históricas: Mathieson et al., 2018. Costa, ríos y áreas montañosas sirven como referencia actual, sin reconstrucción paleoclimática. Pulsa el mapa para ampliar.
Los recién llegados y las comunidades anteriores se mezclaron, con ritmos y proporciones diferentes. El resultado no fue una Europa dividida para siempre entre agricultores y cazadores. Cuando llegamos al Calcolítico ibérico —la Edad del Cobre—, sus habitantes ya descendían de historias combinadas. Podemos descomponer estadísticamente parte de esa ascendencia utilizando muestras antiguas como referencias; eso no convierte los componentes del modelo en tres pueblos originales que coexistieran sin mezclarse.
Esa distinción también afecta a la palabra «anatolio». Un componente relacionado con agricultores neolíticos de Anatolia no dice que los padres de un individuo calcolítico hubieran nacido allí. Describe una afinidad heredada después de muchos siglos de expansión, reproducción y contactos.
Yamna: ganado, ruedas y una geografía abierta
Yamna —habitualmente Yamnaya en la bibliografía internacional— designa un horizonte arqueológico de la estepa póntico-caspiana, al norte de los mares Negro y Caspio, aproximadamente entre 3300 y 2500 a. C. Sus enterramientos en fosas bajo túmulos, o kurganes, son una de sus manifestaciones más reconocibles. La distribución cultural llegó mucho más lejos que su núcleo inicial: el mapa siguiente destaca ese entorno, no una frontera política ni toda su extensión máxima. El estudio de Lazaridis et al. de 2025 revisa su formación y expansión.
El ganado bovino y ovino, los carros y el aprovechamiento de productos animales ayudaban a sostener formas de vida con movilidad. Un carro permite trasladar herramientas, recipientes y pertenencias que una persona no podría cargar a pie. La leche y sus derivados aportan alimento sin tener que sacrificar constantemente animales. La identificación de proteínas lácteas en cálculo dental —la placa mineralizada que puede conservar moléculas de la dieta— ofrece una comprobación independiente del ADN humano. Wilkin y colaboradores documentaron un cambio importante en ese consumo al comienzo de la Edad del Bronce esteparia.
No debemos convertir esa combinación en una escena universal de nómadas a caballo. La intensidad de la movilidad dependía de la región, los recursos y las prácticas de cada comunidad. Un estudio de dieta y subsistencia en las estepas y el norte del Cáucaso muestra por qué hay que atender a contextos locales. Tampoco basta con encontrar caballos para demostrar que se montaban o que tiraban de los carros. La expansión a gran escala de la línea principal de los caballos domésticos actuales se sitúa mucho después de los primeros movimientos yamnaya, alrededor de 2200 a. C., según el análisis de genomas equinos publicado en 2024.
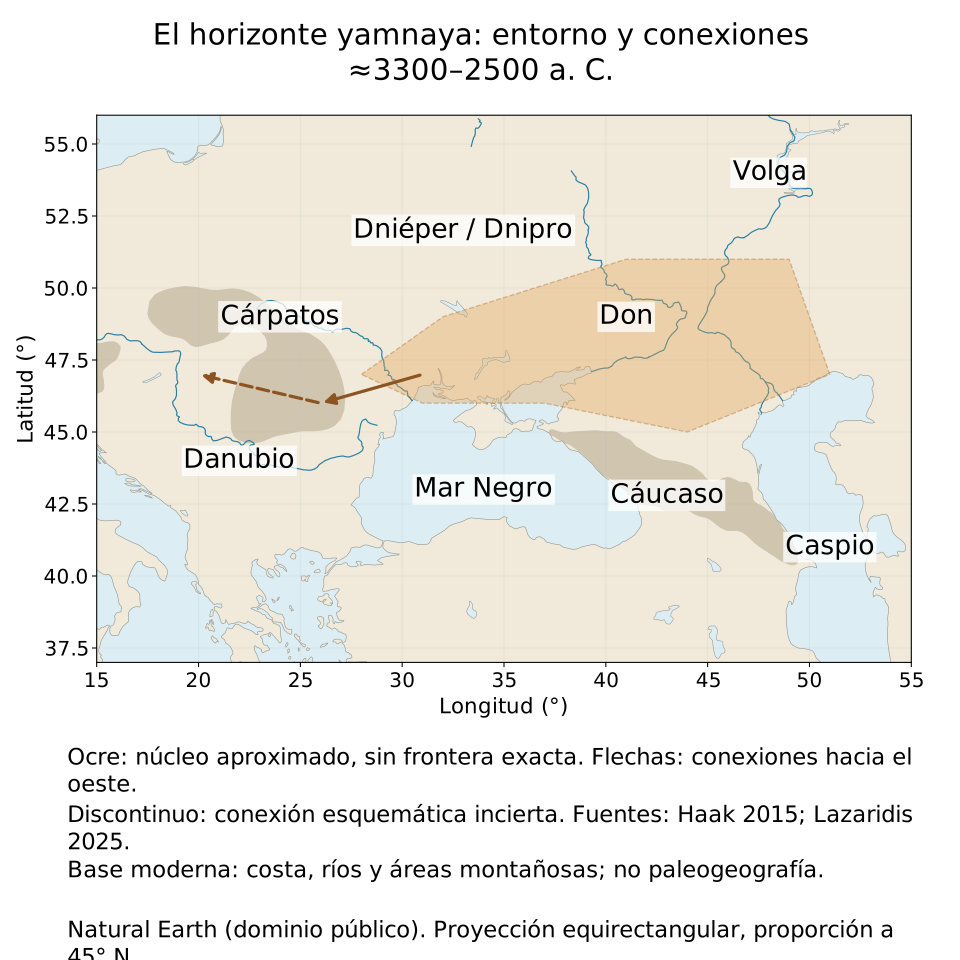
Entorno yamnaya, aproximadamente 3300–2500 a. C. El sombreado ocre aproxima el núcleo geográfico y no delimita una cultura con precisión. Las flechas indican conexiones occidentales; el trazo discontinuo subraya que no conocemos un itinerario exacto. Ríos, costa y regiones montañosas: Natural Earth, dominio público, referencias modernas sin altimetría ni paleocostas. Contexto: Haak et al., 2015 y Lazaridis et al., 2025. Pulsa para ampliar.
La geografía ayuda a plantear posibilidades. Los grandes ríos conectaban ambientes de estepa, bosque y zonas agrícolas. El Dniéper —Dnipro—, el Don y el Volga organizaban espacios de interacción; el bajo Danubio y la cuenca carpática abrían conexiones hacia el centro europeo. Las montañas podían dificultar ciertos movimientos y concentrarlos en pasos y valles. Ninguno de esos rasgos obliga a una ruta única. Un corredor geográfico posible no demuestra que una familia concreta lo utilizara.
Llegar a Iberia llevó generaciones
La señal que encontramos en Iberia no demuestra el viaje directo de un pueblo yamnaya intacto desde la estepa hasta lo que hoy llamamos España. Entre el origen de una ascendencia y su aparición en un territorio pueden mediar siglos, poblaciones intermedias y nuevas mezclas.
En 2015, Haak et al. mostraron una gran relación genética entre muestras yamnaya y personas asociadas a la cerámica cordada de Alemania. En su conjunto estudiado, estas últimas podían modelarse con una aportación de alrededor del 75 % relacionada con la estepa. La cifra pertenece a ese modelo y esas muestras; no define a todos los portadores de cerámica cordada. El hallazgo sustentó movimientos demográficos importantes hacia Europa central y septentrional durante el tercer milenio a. C.
La cerámica cordada recibe su nombre de decoraciones realizadas con impresiones de cuerda. El fenómeno campaniforme, posterior y parcialmente contemporáneo, incluye recipientes con formas características y otras prácticas materiales extendidas por buena parte de Europa. Estos conjuntos arqueológicos proporcionan contexto, pero no son etiquetas genéticas intercambiables.
El trabajo campaniforme de Olalde et al. de 2018 mostró precisamente que un mismo fenómeno material podía difundirse mediante procesos distintos. Individuos de contextos campaniformes ibéricos y centroeuropeos no tenían necesariamente la misma ascendencia. En unas regiones pesaba la transmisión cultural; en otras, la movilidad de personas dejó una huella genética muy grande. Transportar un vaso y tener descendencia en otro lugar son procesos diferentes, aunque puedan coincidir.
Además, el muestreo de Bohemia de Papac et al., 2021 identificó cambios dentro de los propios conjuntos cordados y campaniformes. No hubo una población intermedia inmutable que hiciera de puente para toda Europa. La escala regional revela una sucesión de contactos y reorganizaciones que se pierde al dibujar una sola flecha entre dos extremos del continente.
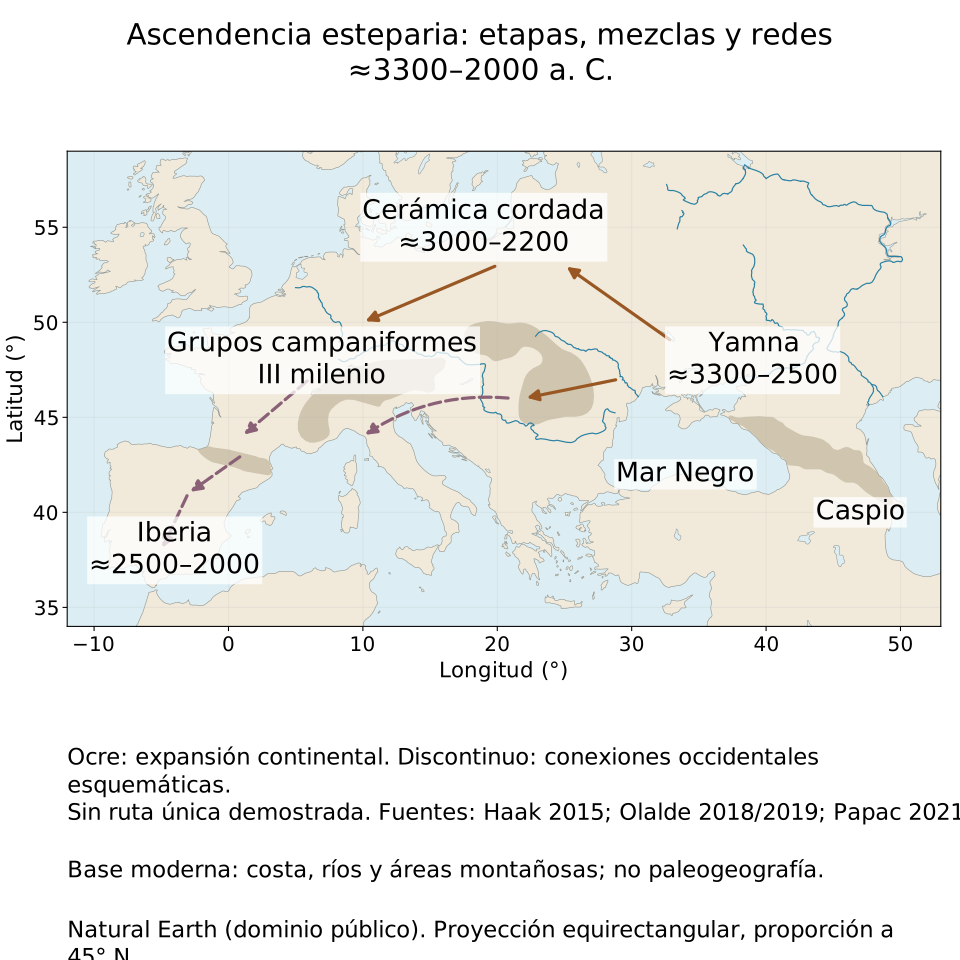
Etapas y redes, aproximadamente 3300–2000 a. C. Las etiquetas son contextos arqueológicos con cronologías regionales variables, no pueblos genéticamente puros. Las conexiones discontinuas occidentales no seleccionan una ruta demostrada; tampoco convierten toda conexión mediterránea en una vía de entrada probada a Iberia. Base moderna: Natural Earth, dominio público. Fuentes: Haak 2015, Olalde 2018, Olalde 2019 y Papac 2021. Pulsa para ampliar.
Para Iberia, comparar con un grupo campaniforme centroeuropeo resulta útil porque esos individuos ya tenían una mezcla de ascendencias. Pero una referencia estadística no es un punto de partida geográfico certificado. Si el grupo de origen real todavía no está muestreado, otro grupo parecido puede funcionar como aproximación. Por eso hay que distinguir la mejor fuente disponible en un modelo de los antepasados concretos que de verdad llegaron.
Una península agrícola en transformación
La Iberia del tercer milenio a. C. no era un espacio vacío a la espera de agricultores o ganaderos. Existían comunidades con campos, rebaños, redes de intercambio y formas muy diferentes de organizar viviendas y enterramientos. Los Millares, en Almería, ilustra la complejidad de algunos asentamientos calcolíticos, con recintos defensivos y una extensa necrópolis. Su ocupación se sitúa aproximadamente entre 3200 y 2200 a. C., según la documentación del enclave de la Junta de Andalucía.
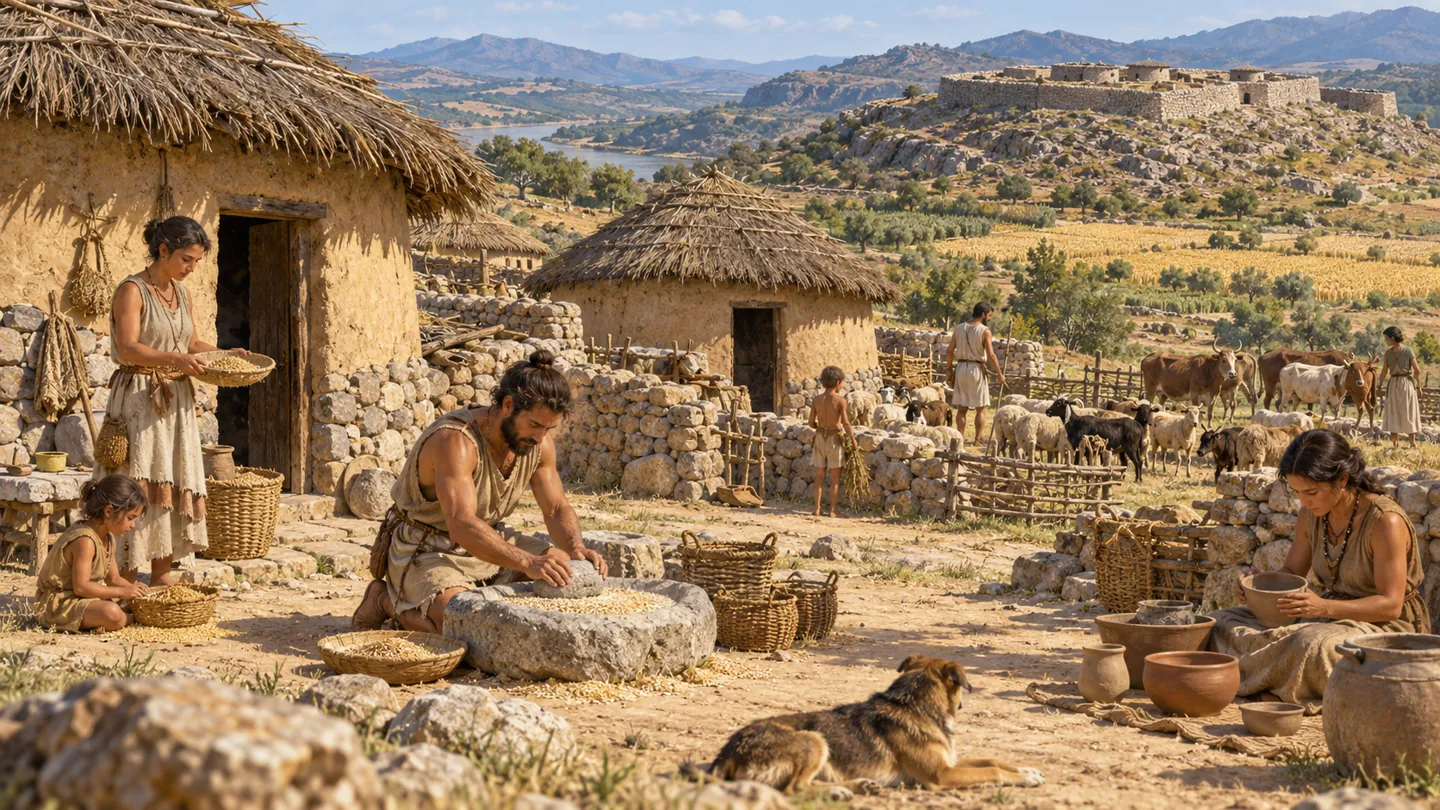
Reconstrucción ilustrativa generada con IA. Sureste ibérico, hacia 2800 a. C., inspirada en Los Millares. Arquitectura doméstica circular, agricultura, ganadería y artesanías proporcionan el marco; cubiertas, vestuario, distribución del poblado y recinto del fondo son elecciones ilustrativas. No representa con exactitud una fase excavada del yacimiento.
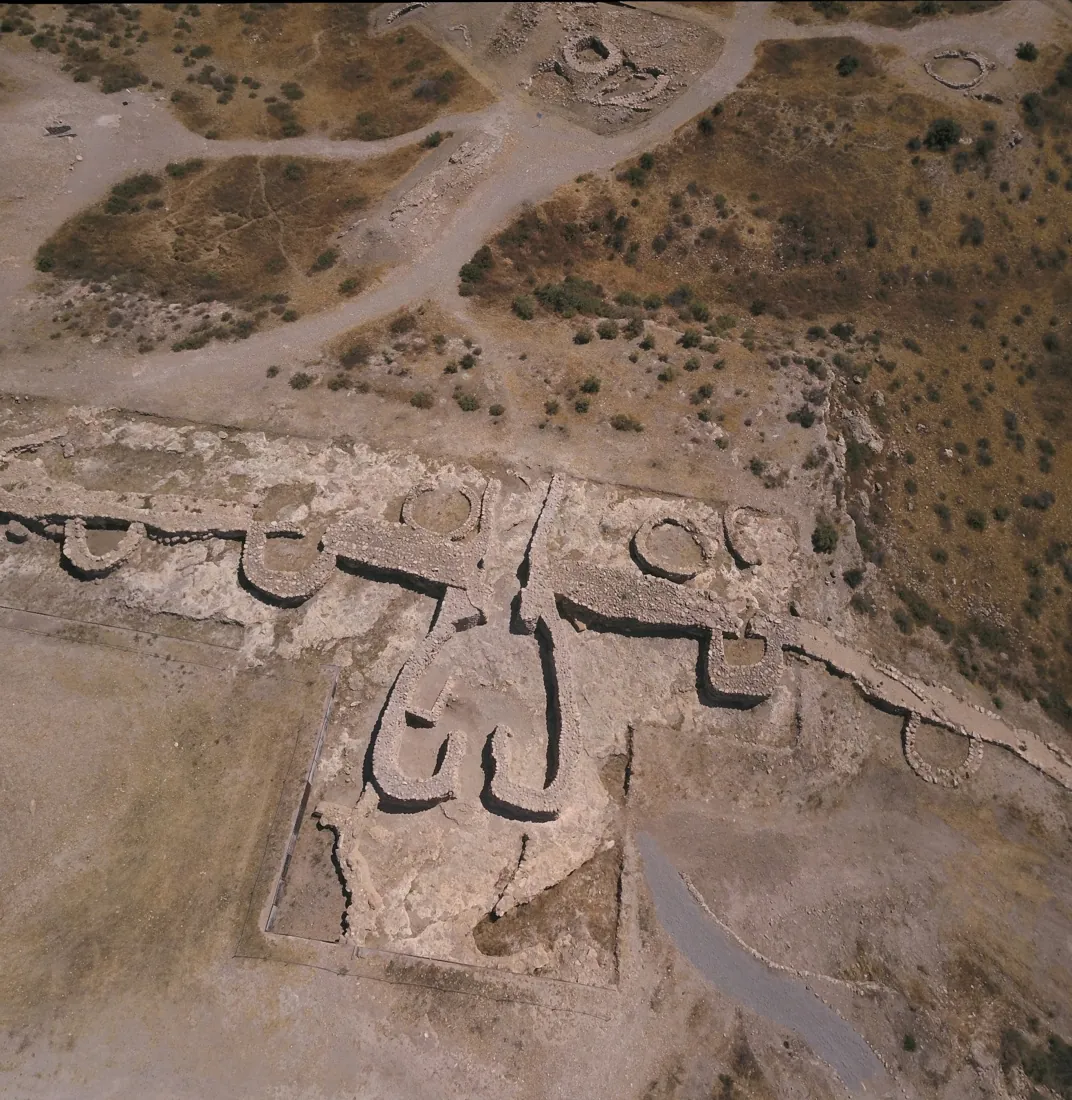
Puerta principal o barbacana de Los Millares, vista desde el oeste-suroeste. Fotografía de Eamand, 31 de octubre de 2017; original y autoría, CC BY-SA 4.0. Redimensionada y convertida a WebP; esta adaptación mantiene la licencia. Es un yacimiento calcolítico ibérico, no yamnaya.

La aparición de ascendencia esteparia en muestras ibéricas del final del Calcolítico y del Bronce es un cambio dentro de esa historia previa. No ocurrió de forma idéntica en toda la península. Las primeras personas detectadas con esa señal podían convivir con otras que no la tenían; las generaciones posteriores muestran mezcla. El tiempo y la distribución de las muestras son necesarios para distinguir una llegada inicial de su difusión y de contactos posteriores.
El estudio de 2019, con 271 individuos ibéricos nuevos y datos previamente publicados, construyó una secuencia de ocho mil años. Iñigo Olalde fue el primer autor; Carles Lalueza-Fox y David Reich participaron como autores de correspondencia junto a él. La investigación dependió de una colaboración internacional de arqueólogos, antropólogos, responsables de colecciones, especialistas de laboratorio y analistas. Las excavaciones y el conocimiento de cada contexto no fueron un complemento ornamental: hicieron interpretable el dato molecular.
Qué significa realmente el «40 %»
En la tabla S11 del suplemento de 2019, el grupo Iberia_BA se modela mediante dos fuentes: Iberia_CA, relacionada con la población calcolítica local, y Germany_Beaker, una referencia campaniforme alemana. La aportación estimada de la segunda es 39,6 %, con un error estándar de 1,0 punto porcentual.
Es una estimación de ascendencia autosómica del conjunto analizado bajo ese modelo. No cuenta el porcentaje de inmigrantes de una aldea ni el de personas que murieron. Tampoco significa «40 % de ADN yamnaya»: la fuente inmigrante aproximada ya incorporaba ascendencia de agricultores y cazadores-recolectores europeos, además de la relacionada con la estepa.
Un ejemplo aritmético inventado ayuda: si una fuente tuviera un 50 % de componente estepario y aportara un 40 % a otra población, contribuiría un 20 % de ese componente. Estos números son didácticos, no un cálculo nuevo del estudio. La operación muestra por qué «aportación de los recién llegados» y «ascendencia esteparia» no son la misma magnitud. Elegir otras fuentes, otros periodos o muestras de otra región también puede cambiar la estimación.
Qué significa el cambio de cromosomas Y
El suplemento, sección SI 5, informa de 30 varones ibéricos del Bronce con cobertura suficiente para asignar R1b-M269: los 30 pertenecían a esa rama. En el subconjunto con resolución adicional, 15 de 15 podían clasificarse como R1b-P312. Esa observación sustenta el cambio casi total de linajes Y descrito en el artículo frente a los conjuntos anteriores; no certifica que cada varón de toda Iberia tuviera el mismo linaje.
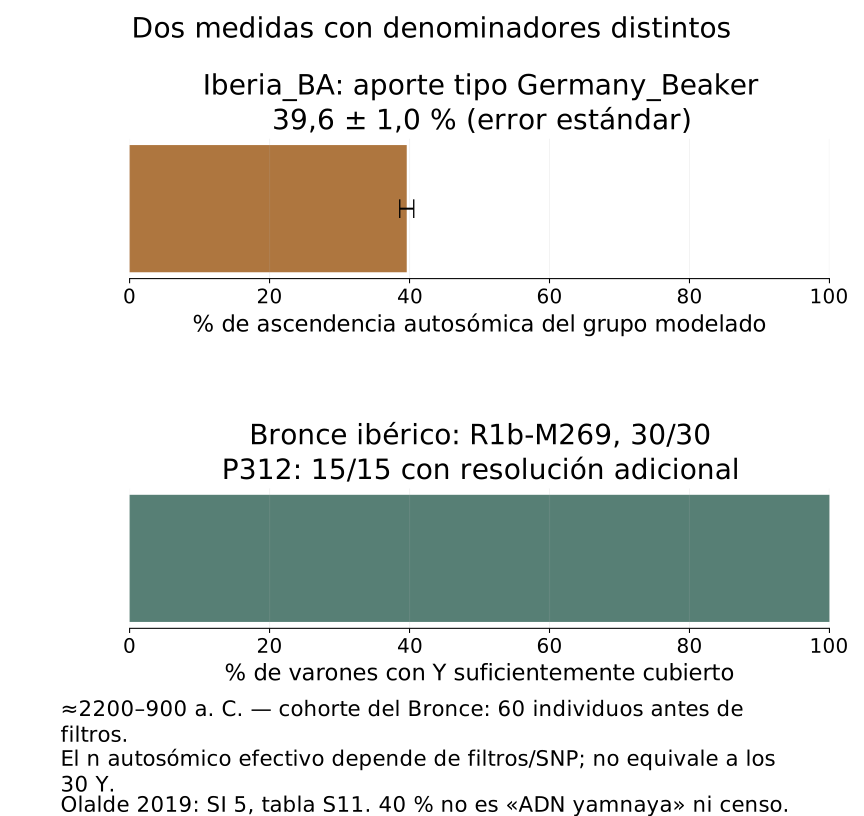
Dos denominadores diferentes. Arriba: coeficiente del modelo autosómico Germany_Beaker + Iberia_CA → Iberia_BA, con ±1 error estándar, no porcentaje directo de ascendencia yamnaya. Abajo: frecuencia observada entre los varones del Bronce con Y suficientemente cubierto. El estudio reunió 60 individuos ibéricos del Bronce antes de filtros —53 nuevos y siete publicados—; el número efectivo autosómico depende de los individuos admitidos y de los SNP disponibles en cada análisis y no se identifica con los 30 Y. Periodo general: aproximadamente 2200–900 a. C.; no representa un censo hacia 2000 a. C. Fuente: Olalde 2019, SI 4–5 y tabla S11. Figura propia; pulsa para ampliar.
Las magnitudes describen cosas distintas. Una población puede conservar mucha ascendencia autosómica anterior mientras cambian radicalmente las frecuencias de sus linajes paternos. Para entender cómo, hace falta entrar en la herencia.
Un haplogrupo es una rama, no una biografía
El ADN humano está organizado en cromosomas. En el esquema cromosómico más frecuente, una persona tiene 22 pares de autosomas, además de cromosomas sexuales. Recibe una copia de cada autosoma de cada progenitor. Durante la formación de óvulos y espermatozoides, las copias se intercambian segmentos: es la recombinación. Por eso los autosomas reúnen piezas procedentes de muchas ramas de la familia.
El cromosoma Y se transmite habitualmente de padre a hijo varón. Gran parte de él —fuera de las regiones que pueden recombinar con X— conserva una transmisión paterna sin la recombinación que redistribuye los autosomas. A lo largo de las generaciones aparecen cambios en la secuencia, o mutaciones. Si un cambio se hereda, puede servir de marcador para identificar descendientes de una misma línea.
Un haplotipo es una combinación de variantes en una región o secuencia. Un haplogrupo agrupa linajes que comparten mutaciones derivadas de un antepasado común. La acumulación de marcadores permite construir un árbol: una rama amplia contiene subdivisiones más recientes. Es preferible nombrar un marcador como M269 o P312 que confiar sólo en una larga combinación de letras y números, porque las nomenclaturas cambian cuando mejora el árbol.
Las mitocondrias son estructuras celulares que poseen su propio pequeño genoma. El ADN mitocondrial se transmite normalmente por vía materna: una madre lo pasa a hijos e hijas; la continuidad entre generaciones se sigue a través de las hijas. Ofrece otra línea uniparental. Ni ella ni la del Y representan toda la genealogía.
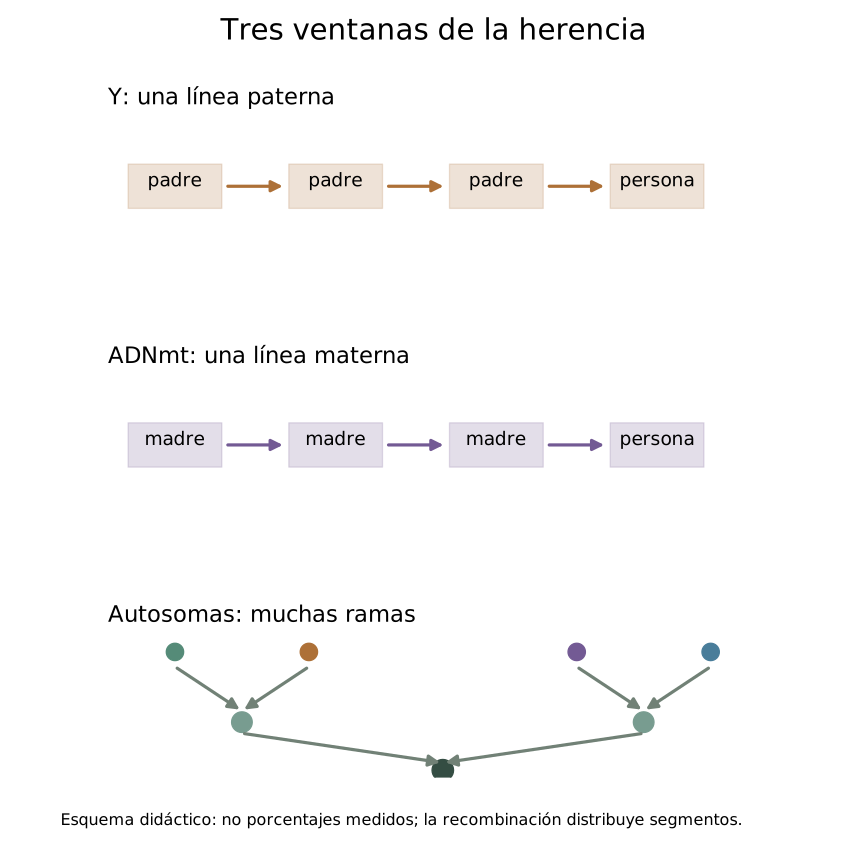
Esquema didáctico propio de la transmisión habitual. El panel autosómico muestra ramas y recombinación, no porcentajes medidos ni un árbol genealógico completo. Referencias metodológicas: Olalde 2019, SI 5 y HaploGrep. Pulsa para ampliar.
Imaginemos un hombre que sólo tiene hijas. Su cromosoma Y no continúa a través de ellas. Sin embargo, una parte de su ADN autosómico sí se transmite, y puede seguir presente en generaciones futuras. Por tanto, la desaparición de un linaje Y no implica la desaparición de toda la ascendencia de quienes lo portaban.
También importa la escala del árbol. En las muestras denominadas Core Yamnaya del estudio de 2025, 49 de 51 asignaciones Y corresponden a R-M269 y 41 de 51 a la subrama R-Z2103. En el Bronce ibérico de 2019 predominan las asignaciones R1b-M269 y, cuando la resolución permite descender, R1b-P312. P312 pertenece a la rama occidental L51; Z2103 es otra rama bajo el ancestro compartido L23. Compartir R1b o M269 no convierte esos linajes en idénticos.
El suplemento ibérico documenta también evidencia de DF27 en algunos varones, pero advierte de la escasa recuperación del marcador: no leer una posición no equivale a ser negativo para su mutación. El estudio del sur ibérico de 2021 añade resolución sobre R1b-Z195, dentro de DF27. En el conjunto sureño anterior al Bronce se documentan I2a, G2a y H2; entre las nuevas muestras del Bronce aparece también una excepción no R1b-M269, un subadulto de La Bastida asignado a E1b1b1a1b1. El panorama yamnaya tampoco es uniforme: el conjunto del Don de 2025 está dominado por I-L699 (17 de 20 asignaciones), distinto de Core Yamnaya. Los sublinajes y la cobertura ayudan a restringir hipótesis; por sí solos no identifican una cultura, una lengua o una identidad. Suplemento de 2021, sección 3 y Lazaridis 2025.
Poner fechas antes de poner flechas
Dos esqueletos genéticamente parecidos pueden estar separados por dos milenios. Sin cronología, una comparación puede confundir una posible fuente de ascendencia con sus descendientes. La secuencia temporal es la diferencia entre observar semejanza y reconstruir un proceso.
El radiocarbono se basa en que el carbono-14 incorporado por los seres vivos decae después de la muerte. Midiendo su cantidad en material apropiado, como colágeno óseo conservado, se estima una edad radiocarbónica. Hay que limpiar y evaluar el material para que la medición corresponda al hueso y no a pegamentos, sedimentos u otras contaminaciones.
Esa edad no es todavía un año del calendario. La cantidad de carbono-14 atmosférico ha variado: se compara la medición con una curva de calibración construida mediante materiales de edad conocida. El resultado suele ser un intervalo, a veces con varios segmentos de probabilidad. Los efectos de reservorio —por ejemplo, determinados recursos acuáticos incorporados a la dieta— pueden desplazar una fecha y requieren valoración específica. La documentación de OxCal explica el programa de calibración y modelado cronológico.
El estudio de 2019 incorporó 26 nuevas fechas directas. Su suplemento distingue las obtenidas en el propio resto humano de las asignadas por contexto arqueológico y especifica OxCal 4.2.3 e IntCal13 como herramientas históricas de calibración. No son una recomendación de usar hoy esa curva en cualquier proyecto. Una fecha contextual puede ser útil, pero suele exigir más cautela: una tumba puede reutilizarse, los huesos pueden desplazarse y un objeto no siempre tiene la misma edad que todos los restos junto a él. Suplemento, SI 1–2.
Del hueso al dato comparable
El ADN antiguo no llega al laboratorio como una cadena humana completa. Los fragmentos suelen ser cortos, escasos y químicamente alterados; pueden coexistir con ADN microbiano y contaminación moderna. Calor, humedad, suelo, prácticas funerarias y conservación posterior afectan a lo que queda. La parte petrosa del hueso temporal y los dientes pueden conservar ADN útil, pero muestrear sigue siendo una intervención sobre restos humanos que requiere permisos y criterio arqueológico.
Una biblioteca de secuenciación es un conjunto de fragmentos preparados con adaptadores e identificadores para que una máquina los lea. La secuenciación produce lecturas: secuencias cortas de bases acompañadas de medidas de calidad. Después hay que decidir qué lecturas pertenecen a cada muestra, cuáles son suficientemente fiables y dónde encajan.
Un SNP —polimorfismo de un solo nucleótido— es una posición donde se observan variantes de una base. Si en cierto lugar unos individuos tienen A y otros G, esas dos versiones son alelos. Comparar un conjunto compartido de posiciones permite construir matrices manejables aunque no se haya reconstruido cada genoma completo.
El estudio ibérico enriqueció bibliotecas para unas 1,2 millones de posiciones del panel llamado 1240k, además del genoma mitocondrial. Enriquecer significa favorecer determinados fragmentos con sondas: no equivale a secuenciar sin selección todo el ADN de un hueso. Las bibliotecas se trataron con UDG parcial, una enzima que reduce gran parte del daño asociado a uracilos y conserva señal en los extremos para evaluar autenticidad. Los detalles están en SI 3 del suplemento.
Preparar, alinear y no contar dos veces
Las herramientas del pipeline histórico tienen tareas concretas:
| Paso | Herramienta o procedimiento documentado en 2019 | Problema que resuelve |
|---|---|---|
| Preparar lecturas | SeqPrep, versión modificada de 1.1 | Recortar adaptadores y unir los dos extremos leídos del mismo fragmento cuando se solapan. |
| Localizar fragmentos | BWA 0.6.1, con samse; referencia nuclear hg19 | Alinear las secuencias a coordenadas comparables; el ADN mitocondrial se alineó a RSRS. |
| Evitar copias repetidas | Eliminación de duplicados según coordenadas y orientación | La amplificación puede producir muchas lecturas de una sola molécula; no deben tratarse como observaciones independientes. |
| Evaluar contaminación | contamMix 1.0.10 y ANGSD | Examinar mezclas mitocondriales y estimar contaminación en X de varones con datos suficientes. |
| Clasificar linajes | HaploGrep2 para ADNmt; marcadores Y con filtros | Comparar mutaciones heredables con árboles de referencia, respetando la resolución disponible. |
Pipeline histórico: Olalde 2019, SI 4–5. Las páginas de software son documentación, no prueba de que se utilizara su versión actual.
El alineamiento no descubre dónde nació una persona. Responde a algo anterior: «¿a qué posición del genoma corresponde este fragmento?». Una lectura muy corta puede encajar en varios sitios; una referencia también puede introducir sesgos. Los filtros de calidad ayudan a limitar esos problemas. Para asignar el Y se exigieron calidad de mapeo y de base de al menos 30.
La contaminación plantea otra pregunta: «¿estamos midiendo a la persona enterrada o parte del ADN de quienes tocaron sus restos?». En un varón con un solo X, diferencias inesperadas entre lecturas de ese cromosoma pueden ayudar a estimar contaminación. No es un detector infalible y necesita cobertura suficiente. Se combina con otras comprobaciones, como el daño característico del ADN antiguo y la coherencia mitocondrial.
Baja cobertura: una base observada no son dos copias conocidas
La cobertura indica cuántas veces se lee una posición. En un autosoma hay dos copias, pero con pocos fragmentos quizá sólo observemos una de ellas. Es arriesgado convertir una única lectura A en el genotipo diploide AA: la otra copia podría ser G.
Para muchas comparaciones, el estudio usó una representación pseudohaploide: en cada posición cubierta se eligió aleatoriamente una lectura y se registró el alelo observado. La persona seguía teniendo dos copias; la matriz retenía una observación por posición. El procedimiento facilita combinar muestras de cobertura desigual, a costa de perder información sobre heterocigosis y de introducir ruido de muestreo.
Si no hay lectura, el valor está ausente. No significa «alelo ancestral», «cero ascendencia» ni «igual a la referencia». El análisis debe manejar explícitamente esos huecos. En 2019 se exigió un mínimo de 10.000 SNP cubiertos para los análisis genómicos y se recortaron extremos de lecturas según el tratamiento de daño. Las conclusiones principales se comprobaron también retirando posiciones CpG susceptibles de errores residuales. SI 4 y 7.
Una tumba con hermanos no equivale a dos muestras independientes
El parentesco se investiga comparando cuántas variantes comparten o difieren entre individuos. En datos de poca cobertura, es necesario estimar la incertidumbre y tener en cuenta la diversidad de fondo. El estudio identificó a los dos individuos de La Braña como hermanos combinando las comparaciones autosómicas, sus linajes uniparentales y segmentos compartidos del X. SI 6.
La relación era un resultado interesante, pero también un problema de muestreo. Si cinco hermanos entran en una comparación como cinco individuos independientes, una familia puede dominar artificialmente la posición de una población. Por eso se excluyeron familiares de primer grado de determinados análisis genómicos, conservando al individuo con mejor cobertura. Para estudiar organización familiar, en cambio, esos vínculos son justamente la información que se busca.
De una matriz enorme a preguntas históricas
Una matriz genética puede organizarse con individuos en filas y variantes en columnas. En datos diploides completos, una celda puede indicar 0, 1 o 2 copias de un alelo. En la representación pseudohaploide, la celda registra una sola base muestreada. El número que introducimos en la matriz depende de la observación disponible, no sólo de la biología que intentamos conocer.
PCA: un mapa de variación, no un mapa de migraciones
El análisis de componentes principales, o PCA, busca combinaciones de columnas que resumen parte de la variación entre filas. Su primer eje recoge la mayor variación posible bajo el preprocesamiento elegido; el segundo recoge la mayor parte restante que puede expresarse en una dirección perpendicular al primero. Reducir miles de dimensiones a dos facilita ver afinidades, gradientes y muestras inusuales.
Los ejes no son países, fechas ni porcentajes de ascendencia. También dependen de quién entra en el análisis, de las variantes seleccionadas y de cómo se tratan los datos. Dos puntos próximos pueden compartir historia, pero la proximidad no demuestra por sí sola una migración, ni su dirección, ni su fecha. Sobre el método: Patterson, Price y Reich, 2006.
En 2019 se utilizó smartpca, de EIGENSOFT: los ejes se calcularon con individuos actuales y sobre ellos se proyectaron los antiguos, con opciones para manejar la proyección y su contracción. No se trató de rellenar ingenuamente todos los huecos y recalcular un PCA con todos los individuos juntos. Suplemento, SI 8.
Una demostración pequeña y enteramente sintética
La siguiente figura usa 12 individuos ficticios y 18 variantes inventadas, sin etiquetas de poblaciones históricas. Las frecuencias cambian suavemente entre individuos y hay variación aleatoria: no se han creado bloques puros. De 216 celdas, 36 están ausentes. Es una demostración de álgebra, no una reproducción ni evidencia del estudio ibérico.
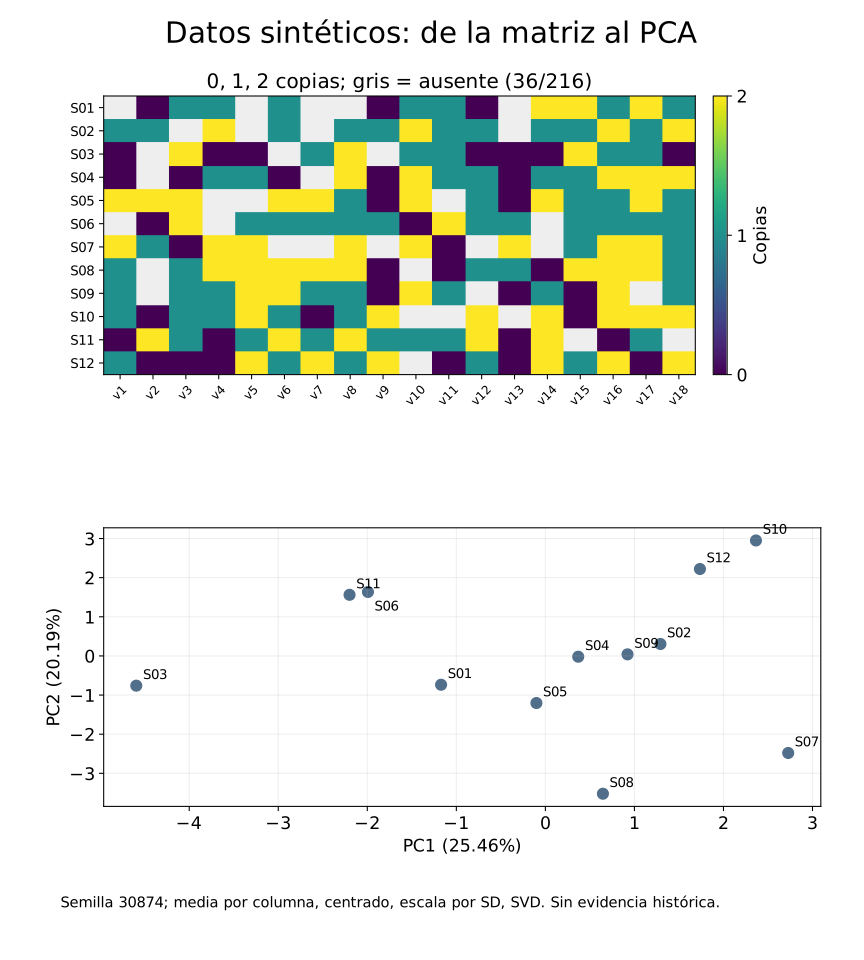
Datos sintéticos. Semilla 30874; genotipos diploides 0/1/2, ausencias aleatorias independientes del genotipo, imputación por media de columna, centrado y escalado por desviación estándar muestral después de imputar, eliminación de columnas invariantes y descomposición SVD. PC1 resume 25,46 % y PC2 20,19 % de la variación de esta matriz procesada. Elaboración propia; no es el PCA de 2019. Datos CSV, script completo ejecutado y resultado numérico. Pulsa para ampliar.
El núcleo del cálculo, una vez construida la matriz M, es breve:
# Ejemplo sintético diploide, NO pipeline de ADN antiguo.
media = np.nanmean(M, axis=0)
completa = np.where(np.isnan(M), media, M)
centrada = completa - media
sd = centrada.std(axis=0, ddof=1)
Z = centrada[:, sd > 0] / sd[sd > 0]
U, s, Vt = np.linalg.svd(Z, full_matrices=False)
puntos = U[:, :2] * s[:2]
Imputar la media evita que el ordenador intente operar con una ausencia como si fuera un número observado; también acerca esa celda al centro y puede deformar la estructura. Es una decisión explícita para el juguete didáctico, no una recomendación para analizar ADN antiguo. El script completo permite repetirlo con NumPy y comprueba centrado, escala, valores finitos y reconstrucción de la matriz por SVD. Cambiar el signo de un eje produciría una figura reflejada con el mismo contenido matemático.
Estadísticas f4: comparar afinidades de forma explícita
Una visualización sugiere preguntas. Una estadística permite contrastarlas. Las f4 comparan diferencias de frecuencias de alelos entre cuatro poblaciones. De forma esquemática, se promedia sobre muchas variantes el producto (pA − pB) × (pC − pD), donde cada p es la frecuencia de un alelo.
Si las diferencias entre A y B se asocian sistemáticamente con las de C y D, la estadística puede alejarse de cero. Bajo una historia en árbol adecuada, una expectativa nula permite investigar si hay relaciones de afinidad que ese árbol no explica. El signo cambia al cambiar el orden de las poblaciones. Una desviación requiere interpretar el modelo y las alternativas: no contiene por sí misma una dirección única de migración ni un relato completo. Patterson et al., 2012.
Olalde et al. calcularon f4 con qpDstat, de ADMIXTOOLS, activando f4mode: YES. Es una opción concreta: una f4 y una D relacionada no son números intercambiables. La documentación oficial de qpDstat describe la distinción.
qpAdm: una mezcla compatible no es la única historia verdadera
qpAdm contrasta si una población objetivo puede representarse mediante una combinación de fuentes en sus relaciones con un conjunto de poblaciones de referencia. Esas referencias deben distinguir las fuentes lo suficiente; no necesitan ser espectadores completamente ajenos a toda la historia. La elección de conjuntos y las relaciones no modeladas afectan al resultado.
El programa estima coeficientes de mezcla y evalúa restricciones sobre una matriz de estadísticas f4. El resultado puede mostrar que una sola fuente es insuficiente o que una combinación de dos fuentes es compatible. Pero las fuentes suelen ser aproximaciones: individuos muestreados que representan relaciones genéticas, no necesariamente los progenitores históricos exactos.
Un valor p alto no significa «hay un 90 % de probabilidad de que esta historia sea verdadera». Bajo las hipótesis del contraste, indica que no observamos una discrepancia suficientemente fuerte para rechazar esas restricciones con los datos disponibles. Varios modelos pueden superar el contraste. Un muestreo limitado, fuentes parecidas o una historia de flujo continuo pueden impedir distinguirlos. La evaluación de Harney et al., 2021 y su guía suplementaria explican estas limitaciones.
En Iberia, este enfoque ayuda a separar la fuente calcolítica local de una fuente inmigrante ya mezclada. El suplemento de 2019 advierte que atribuir toda la ascendencia neolítica europea a la población local es inadecuado: parte llegó también con los grupos que aportaron ascendencia esteparia. Precisamente por eso una mezcla «Iberia local + yamnaya» puede ser una simplificación insuficiente.
Incertidumbre: no hay un millón de pruebas independientes
Las variantes próximas pueden heredarse juntas, de modo que contarlas como observaciones independientes subestimaría el error. El block jackknife divide el genoma en bloques y repite el cálculo dejando fuera uno cada vez. La variación entre esas estimaciones permite calcular errores estándar teniendo en cuenta parte de esa dependencia.
El trabajo de 2019 utilizó bloques de 5 megabases para las f4 y de 10 megabases en su comparación específica de X y autosomas. Una megabase es un millón de posiciones. El tamaño del bloque, la cobertura y el número de regiones disponibles importan. La barra de error expresa incertidumbre estadística bajo el análisis; no incorpora automáticamente todos los sesgos arqueológicos o todas las historias posibles. SI 9 y 11.
Hombres, mujeres y lo que una señal paterna no cuenta
La ascendencia esteparia aparece en hombres y mujeres. El cromosoma Y sólo observa una línea paterna; no permite afirmar que la nueva ascendencia estuviera restringida a varones.
Para investigar aportaciones distintas según el sexo, se puede comparar el X con los autosomas. En el esquema habitual y bajo un equilibrio simple de sexos, las mujeres portan dos X y los hombres uno; en el conjunto de copias X, alrededor de dos tercios proceden de madres y un tercio de padres. Los autosomas reciben aportaciones iguales de ambos progenitores. Una contribución inmigrante especialmente masculina puede dejar menos ascendencia relacionada con esa fuente en X que en autosomas.
La comparación no es un contador directo de cuántos hombres viajaron. Depende de la secuencia de mezcla, las fuentes elegidas, el tiempo transcurrido y la incertidumbre. En 2019, el contraste apuntó a menos aportación tipo Germany_Beaker en X, con Z = 2,64 y errores amplios. Esa señal acompañaba el cambio mucho más llamativo de Y. El conjunto sostuvo una interpretación de aportaciones sesgadas, pero no fijó un mecanismo social único. SI 11, tabla S14.
El trabajo del sureste de Villalba-Mouco et al., 2021, centrado especialmente en sociedades de El Argar, no detectó un sesgo masculino significativo de ascendencia esteparia mediante sus modelos de X y autosomas. El estudio de Portugal de 2025 tampoco lo detectó en sus conjuntos del Bronce. Esto impide convertir el patrón paterno en una regla idéntica para toda Iberia. No detectar una diferencia tampoco demuestra que jamás existiera: una muestra posterior puede registrar mezclas ya equilibradas y el X ofrece menos información.
Las hipótesis sociales incluyen efectos fundadores, organización patrilineal —afiliación o transmisión de posición social por línea paterna—, residencia patrilocal —vivir cerca del grupo del varón—, diferencias de éxito reproductivo o migraciones sucesivas. Pueden actuar combinadas. Hay que contrastarlas con parentesco, distribución de tumbas, movilidad isotópica y arqueología de los asentamientos.
El ADN no permite deducir automáticamente matanzas, expulsiones ni conquista militar. Tampoco revela preferencias personales de las mujeres o acuerdos concretos entre familias. La violencia puede estudiarse cuando hay traumatismos y contextos que la documenten; no es la traducción obligatoria de una barra de haplogrupos.
Lo que se precisó después de 2019
La investigación posterior no convierte el resultado inicial en una fotografía definitiva. Lo hace más regional, más cronológico y más exigente con sus interpretaciones.
El sureste ibérico, 2021. Villalba-Mouco y colaboradores estudiaron 136 individuos, de los que 122 aportaron datos para los análisis poblacionales más detallados. Su secuencia vincula la extensión de ascendencia esteparia por el sur con la transición alrededor de 2200 a. C. y el surgimiento de El Argar, e investiga parentesco y organización social. El cambio de Y es muy marcado; las relaciones familiares son compatibles con una organización patrilineal y prácticas de exogamia femenina, sin convertirlas en una descripción universal de todas las casas. También aparecen afinidades mediterráneas que obligan a considerar más de una aportación externa. Artículo y materiales adicionales.
Portugal, 2025. El trabajo de Roca-Rada et al. amplía la historia del extremo occidental y muestra diferencias entre conjuntos y modelos. Registra niveles bajos de afinidad esteparia en determinados contextos campaniformes, una difusión mayor durante el Bronce y persistencias locales. Como ya hemos visto, el cambio de linajes paternos y la comparación X/autosomas no entregan exactamente la misma conclusión. Genome Biology.
El noreste, 2025–2026. El estudio de Los Castellets II examinó 24 adultos del Bronce final e identificó numerosos parientes: otra advertencia contra confundir una colección funeraria con una muestra aleatoria. Sus análisis sugieren un incremento regional de ascendencia esteparia, pero algunas comparaciones no alcanzan significación estadística. Un trabajo de 2026 sobre comunidades del Hierro obtuvo datos genómicos de 22 individuos a partir de 54 enterramientos de recién nacidos y documentó continuidad con poblaciones derivadas del Bronce junto a cambios posteriores. Son ventanas regionales y socialmente selectivas, no sustitutos de toda la península. Los Castellets II y estudio del Hierro.
El origen de los propios yamnaya, 2025. Lazaridis, Patterson, Anthony y una amplia colaboración internacional sitúan su formación en redes anteriores de mezcla entre el Cáucaso, el bajo Volga y las poblaciones de la región Dniéper–Don. El modelo de una población esteparia original y pura se vuelve aún menos adecuado. El estudio también propone vínculos con la expansión de las lenguas indoeuropeas, pero el ADN no conserva el idioma que hablaba una persona: esa reconstrucción requiere argumentos lingüísticos y arqueológicos adicionales. Nature, con suplemento y tablas.
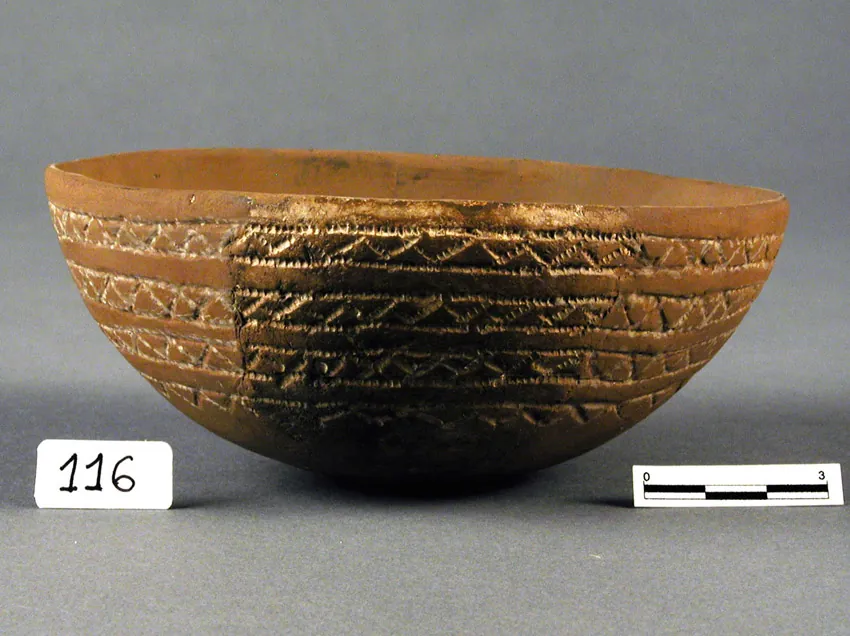
Cuenco de la sociedad de Los Millares, Museo de Almería. Fotografía y obra propia de Museo de Almeria, según la ficha original; CC BY-SA 3.0. Convertida a WebP, con la misma licencia. El objeto pertenece al contexto calcolítico ibérico; no se presenta como cerámica yamnaya ni como un marcador genético.

Una colección de enterramientos no es un censo
La conservación decide qué vidas podemos estudiar. Una región cálida puede proporcionar menos ADN que otra; la cremación puede destruirlo; un cementerio puede concentrar un grupo social; una excavación puede recuperar mejor unas fases que otras. Después, los filtros técnicos seleccionan las muestras que permiten determinados análisis.
Ese proceso tiene dos consecuencias. Presencia es una observación: hemos encontrado una señal en una persona de un contexto y una fecha. Ausencia en las muestras no garantiza ausencia en toda la población. Y una frecuencia dentro de una colección no debe convertirse sin más en la frecuencia de millones de personas que nunca hemos muestreado.
También los modelos tienen límites. Un grupo ancestral no muestreado puede parecerse a una de las fuentes disponibles. Distintas historias pueden producir afinidades parecidas. Más cobertura mejora lo que conocemos de un individuo, pero no corrige por sí sola una distribución geográfica sesgada. Más individuos ayudan, pero cien familiares de un único cementerio no cubren cien comunidades independientes.
La inferencia más sólida combina métodos que fallan de maneras distintas: fechas directas, estratigrafía, ADN autosómico, linajes, parentesco y señales isotópicas de movilidad. Si todos apuntan hacia un proceso compatible, aumenta nuestra confianza; si discrepan, la diferencia puede señalar una historia más compleja o un problema que revisar.
¿Qué papel tuvo el aprendizaje automático?
El PCA pertenece al repertorio del aprendizaje no supervisado: extrae estructura sin recibir etiquetas de «origen verdadero» para cada individuo. Es además una técnica estadística clásica. Llamarlo aprendizaje automático puede ser correcto; presentar toda la investigación como inteligencia artificial ocultaría las tareas y supuestos que realmente importan.
En los resultados centrales de 2019, la exploración visual se realizó con PCA y las hipótesis de afinidad y mezcla se contrastaron con estadísticas f y qpAdm. Las fuentes no atribuyen esas conclusiones a redes neuronales. Alinear lecturas, medir contaminación, clasificar haplogrupos y calcular contrastes estadísticos tampoco se vuelven la misma operación por ejecutarse en un ordenador.
Las herramientas actuales pueden facilitar pipelines reproducibles y nuevos análisis, pero hay que distinguirlas del software histórico. Para aprender hoy se pueden consultar ADMIXTOOLS, EIGENSOFT o ADMIXTOOLS 2. No hemos reanalizado aquí los genomas ibéricos con sus versiones actuales ni reemplazado los resultados publicados por el ejemplo sintético.
Volver al fragmento que sostiene la historia
El depósito ENA PRJEB30874 permite acceder a secuencias del estudio. Su informe de archivos lista lecturas FASTQ y archivos BAM depositados con índices BAI. FASTQ guarda secuencias y calidades; BAM organiza lecturas alineadas. No es una tabla ya interpretada de porcentajes de ascendencia. Las matrices comparativas, identificadores, fechas, fuentes de referencia y filtros siguen siendo necesarios para reproducir un análisis.
Esa posibilidad de regresar desde una afirmación a sus datos es una de las aportaciones decisivas de la computación. No se limita a acelerar cuentas: hace posible ordenar observaciones, repetir un contraste, cambiar una fuente aproximada y comprobar cuánto depende una conclusión de esa elección. Pero una cifra reproducible aún necesita una interpretación histórica responsable.
Las personas de Castillejo del Bonete no dejaron un registro de sus antepasados. Sus huesos conservan, de manera incompleta, fragmentos de las relaciones que los unían a otros seres humanos. Al compararlos con restos de distintos lugares y fechas, descubrimos que la transición al Bronce ibérico incluyó movimientos demográficos profundos y mezclas duraderas. Lo que todavía no podemos escribir con la misma seguridad es una biografía colectiva única: quién tomó cada camino, qué negociaron las familias o por qué unos linajes tuvieron más descendientes que otros.
La pregunta inicial admite, por tanto, una respuesta precisa: reconstruimos una migración comparando fragmentos fechados, contrastando modelos y delimitando lo que los datos no resuelven. El ordenador permite oír una señal que antes era inaccesible. La arqueología nos obliga a recordar que esa señal procede de vidas, no de bloques de colores.
Bibliografía y recursos
- Olalde, I., et al. (2019). “The genomic history of the Iberian Peninsula over the past 8000 years”. Science, 363, 1230–1234. DOI: 10.1126/science.aav4040, texto abierto, suplemento: contextos, laboratorio y métodos SI 1–11; tablas S11–S14.
- Haak, W., et al. (2015). “Massive migration from the steppe was a source for Indo-European languages in Europe”. Nature, 522, 207–211. DOI: 10.1038/nature14317, texto abierto, suplemento.
- Olalde, I., et al. (2018). “The Beaker phenomenon and the genomic transformation of northwest Europe”. Nature, 555, 190–196. DOI: 10.1038/nature25738.
- Mathieson, I., et al. (2018). “The genomic history of southeastern Europe”. Nature, 555, 197–203. DOI: 10.1038/nature25778.
- Villalba-Mouco, V., et al. (2021). “Genomic transformation and social organization during the Copper Age–Bronze Age transition in southern Iberia”. Science Advances, 7, eabi7038. DOI: 10.1126/sciadv.abi7038, texto y materiales adicionales.
- Papac, L., et al. (2021). “Dynamic changes in genomic and social structures in third millennium BCE central Europe”. Science Advances, 7, eabi6941. DOI: 10.1126/sciadv.abi6941.
- Lazaridis, I., Patterson, N., Anthony, D., et al. (2025). “The genetic origin of the Indo-Europeans”. Nature, 639, 132–142. DOI: 10.1038/s41586-024-08531-5, suplemento y tablas.
- Roca-Rada, X., et al. (2025). “The genetic history of Portugal over the past 5,000 years”. Genome Biology, 26, 248. DOI: 10.1186/s13059-025-03707-2.
- Harney, É., Patterson, N., Reich, D. y Wakeley, J. (2021). “Assessing the performance of qpAdm: a statistical tool for studying population admixture”. Genetics, 217, iyaa045. DOI: 10.1093/genetics/iyaa045.
- Patterson, N., Price, A. L. y Reich, D. (2006). “Population Structure and Eigenanalysis”. PLOS Genetics, 2, e190. DOI: 10.1371/journal.pgen.0020190. Patterson, N., et al. (2012). “Ancient Admixture in Human History”. Genetics, 192, 1065–1093. DOI: 10.1534/genetics.112.145037.
- Wilkin, S., et al. (2021). “Dairying enabled Early Bronze Age Yamnaya steppe expansions”. Nature, 598, 629–633. DOI: 10.1038/s41586-021-03798-4. Librado, P., et al. (2024). “Widespread horse-based mobility arose around 2200 BCE in Eurasia”. Nature, 631, 819–825. DOI: 10.1038/s41586-024-07597-5.
Revisión de fuentes: octubre de 2026. Los créditos y las licencias de las fotografías aparecen en sus pies; los mapas y gráficos son elaboraciones propias y la cartografía de base es de dominio público. Las imágenes con IA son ilustraciones ambientales y no se utilizan como evidencia científica.