Un fichero contiene José, pero después de pasar por un pipeline aparece José. Otro conserva las tildes, aunque una búsqueda de Jose devuelve también José. Y en un tercero los emojis se convierten en ?.
Los tres casos parecen problemas de texto, pero conviene investigar causas distintas: cómo interpretamos los bytes, cómo comparamos las cadenas y qué información se ha perdido durante el recorrido. Cambiar a UTF-8 sin localizar el fallo puede limitarse a guardar correctamente un texto que ya estaba estropeado.
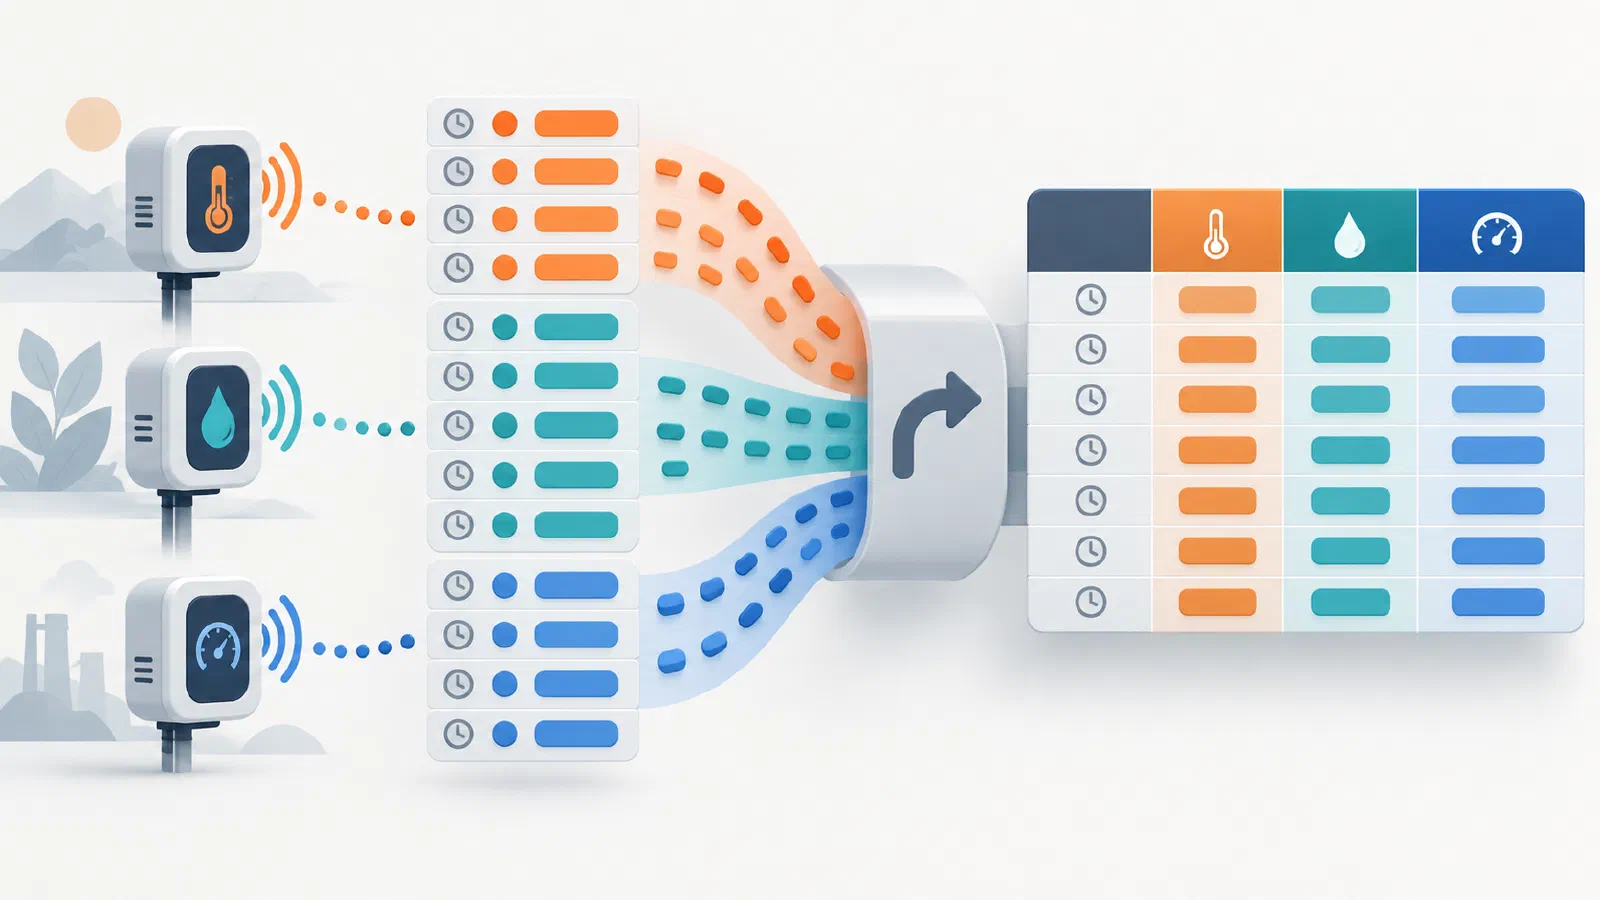
Imagina que recibes lecturas de sensores cada cinco minutos. Cada mensaje contiene un instante, el sensor que lo envió, el nombre de una métrica y su valor. Guardar los mensajes tal como llegan es cómodo: si mañana aparece una métrica nueva, basta con recibir más filas. Pero el informe que consume esos datos pide otra cosa: una fila por instante y sensor, con temperatura, humedad y presión en columnas separadas.
Hay herramientas que resuelven una tarea concreta y otras que terminan convirtiéndose en el cajón de herramientas entero. DBeaver pertenece a la segunda categoría: es un cliente de bases de datos multiplataforma desde el que podemos conectarnos, consultar, explorar, editar y exportar datos sin cambiar de aplicación. Para un data engineer, se parece bastante a una navaja suiza con una interfaz gráfica.
Python sigue siendo uno de los lenguajes más cómodos para explorar y transformar datos. Sin embargo, la comodidad de un DataFrame no siempre se traduce en velocidad: cuando crecen las columnas y las filas, el coste de memoria y de CPU se vuelve muy visible. Polars aborda ese problema con una librería de DataFrames escrita en Rust y con una API disponible desde Python.
Hay herramientas que aparecen en los pipelines de datos porque una gran empresa las impone y otras que se extienden porque resuelven un problema cotidiano con una elegancia difícil de ignorar. DuckDB pertenece a la segunda categoría. Es una base de datos analítica embebida, pequeña, rápida y capaz de consultar archivos locales o remotos con SQL. En los últimos años se ha convertido en una pieza habitual del trabajo de Data Engineering, Data Science y Analytics Engineering.
